从进程爆炸到cgroup v2原子熔断:Mopheus运行时资源看门狗的架构演进与四阶段设计
用四级级联配置、双模看门狗与cgroup v2体系,为自主智能体构建确定性的物理资源边界
当AI智能体(Agent)从单纯的文本聊天走向真实的软件工程现场,它开始自主调用Bash、启动本地开发服务器、并发编译工程、甚至递归派生数十个Subagent协作。随之而来的工程风险不再仅仅是“代码写得对不对”,而是极其现实的生产稳定性隐患:递归Subagent导致的进程爆炸(Fork炸弹)、内存泄漏撑爆宿主机触发Linux OOM Killer误杀核心服务、以及死锁或限流造成的僵死任务长时间占满并发插槽。
为此,Mopheus构建了一套运行时任务资源守卫(Runtime Task Guard)与熔断看门狗体系。本文将复盘这套体系从Phase 1到Phase 4的演进历程,拆解我们如何在多租户、非Root环境下,结合轻量采样、Linux cgroup v2进程树销毁、四级级联配置与数据驱动的峰值画像,为Agent执行构建兼具弹性与确定性边界的系统防护。
01核心工程挑战:当智能体拥有真实的系统执行权
在Mopheus的架构中,Agent不是运行在虚构的沙盒玩具里,而是通过Mopheus Daemon运行在真实的物理机、虚拟机或工作站上,拥有真实的Git Worktree和系统执行上下文。这种深度执行能力带来了极高的生产力,但在高并发多任务场景下也随之带来了三类严峻的系统级风险:
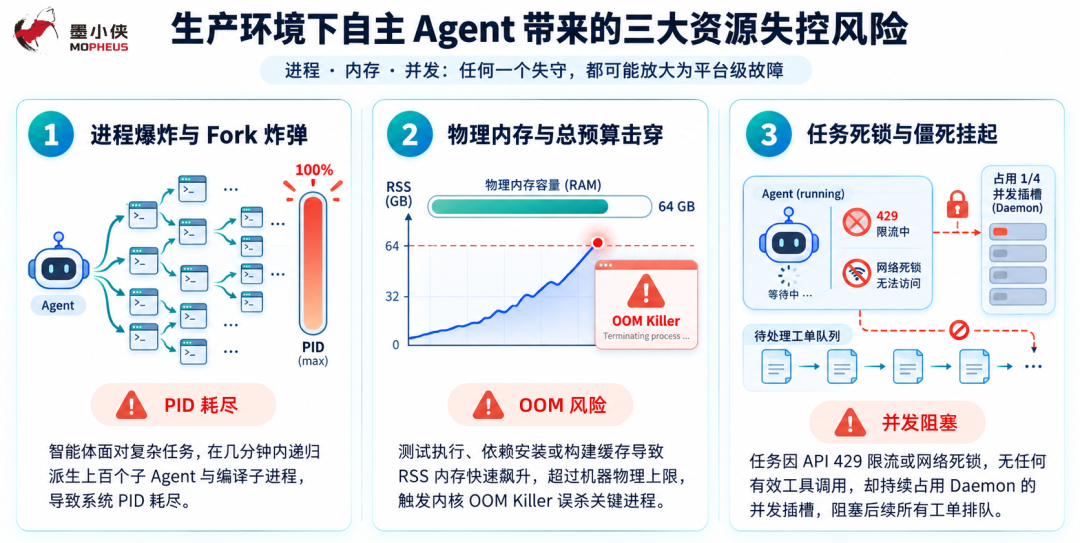
图1:生产环境下自主Agent带来的三大资源失控风险
传统的简单做法通常是给任务设一个固定超时时间,或者在任务结束时执行kill -9 $PID。然而在真实工程实践中,这种粗粒度方案存在致命缺陷:
1.孤儿进程逃逸:如果Agent创建了多级孙子进程,直接杀死根进程会导致子进程被systemd(PID 1)收养,在后台继续疯狂消耗CPU与内存;
2.缺乏预警与宽限期:突发内存增长直接强杀会导致即将完成的代码生成前功尽弃,缺乏阶梯式的告警与冷静期;
3.配置僵化:不同机器规格(4核8G测试机 vs 64核256G编译机)与不同租户工作区的安全策略迥异,无法用一套静态配置通吃。
02全景拓扑:四级配置级联与运行态数据流
为了兼顾不同租户的管控灵活性与单台机器的物理安全性,Mopheus为配置来源建立了清晰的四级优先级显式覆盖(Precedence Overlay)机制:
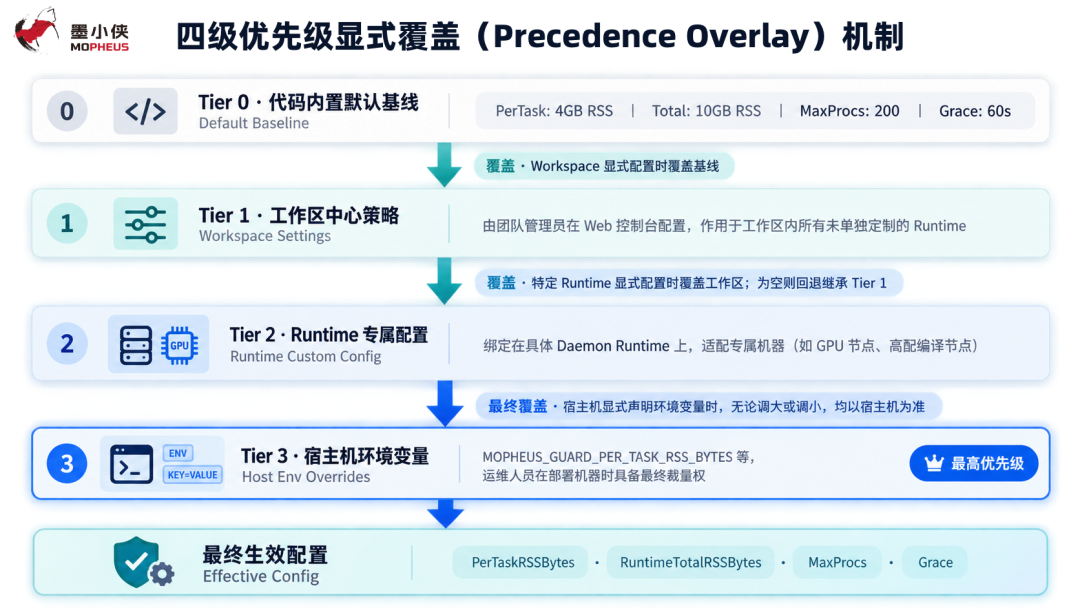
图2:Mopheus的四级优先级显式覆盖机制
层级覆盖原则:各层级之间严格遵循“高优先级显式设置即覆盖(Precedence Override)”。例如,如果宿主机通过Tier 3环境变量设置了32GB内存,无论云端Tier1/2设置的是4GB还是16GB,均无条件以宿主机的32GB为准。
在这套拓扑下,系统运行时调度器的执行链路如下:
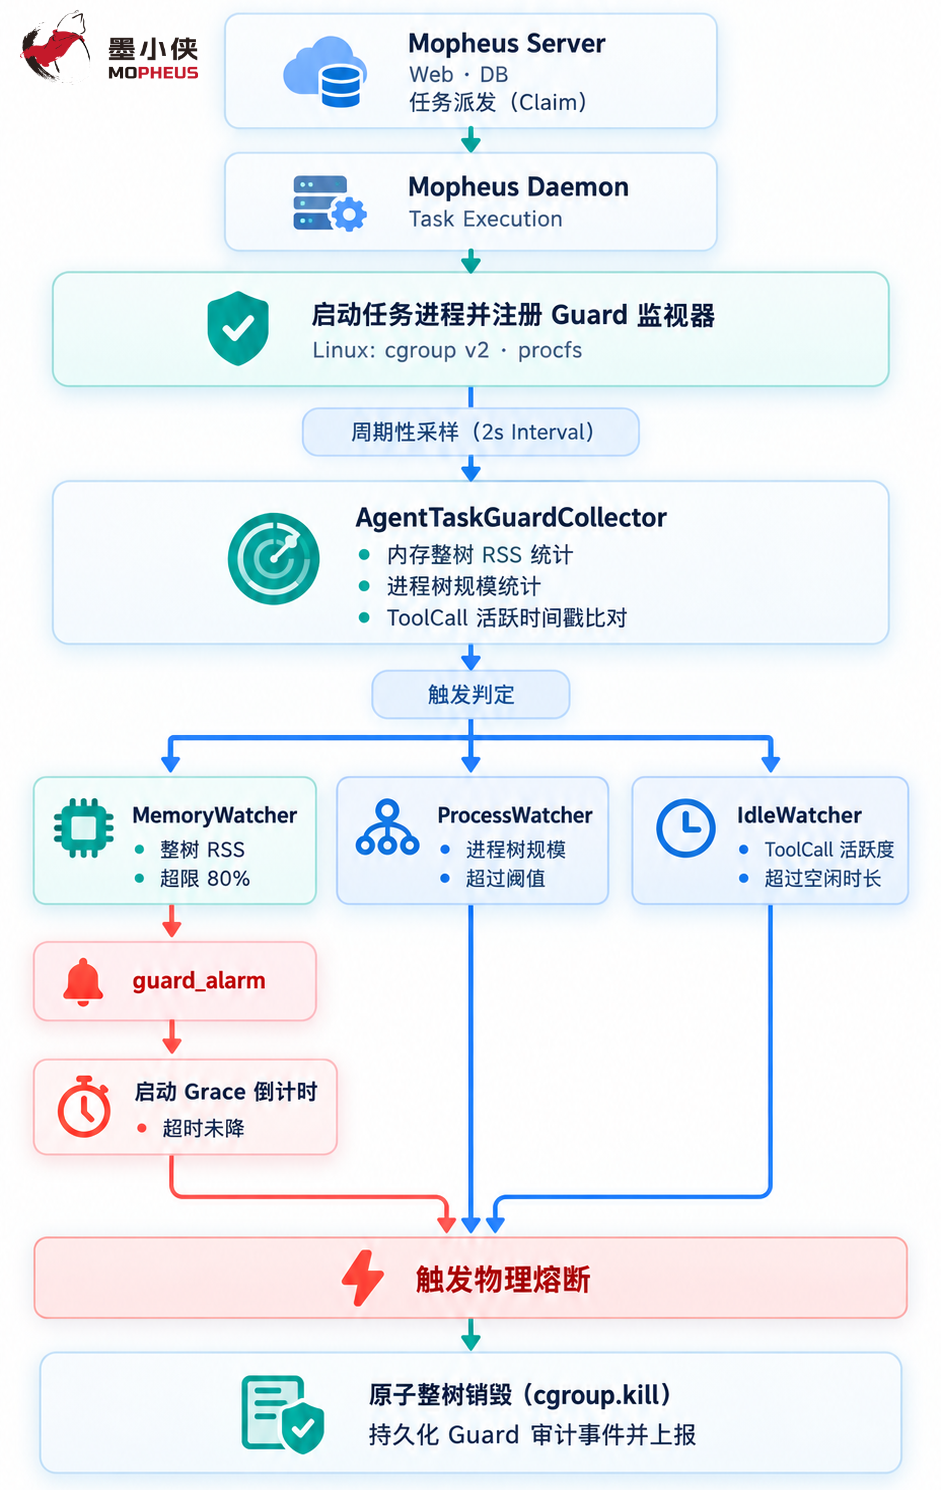
图3:系统运行时调度器的执行链路
03四阶段演进:从被动监视到自适应治理
Mopheus运行时看门狗的设计并非一蹴而就,而是沿着“被动捕获 → 确定性物理隔离 → 峰值数据画像 → 系统级多维柔性治理”的路径清晰演进。
Phase 1:内存与进程看门狗与熔断基石(In-Memory Watchdog)
在Phase 1中,核心目标是以极低系统开销建立起第一道“防爆大堤”,实现任务进程树的实时可观测性与异常熔断。
1)2秒高效采样管道
Daemon调度器内置了AgentTaskGuardCollector,每2秒对当前节点上所有运行中的agent_task进行一次聚合采样:
· 高效整树进程扫描:优先使用Linux cgroup v2控制器,并在未启用cgroup或旧内核环境下平滑回退到procfs递归扫描(/proc/[pid]/task/*/children),精确计算出当前任务派生出的整棵子进程树的PID列表。
· 物理内存聚合:累加整树所有子进程的RSS(Resident Set Size),避免漏算子编译器或外部测试进程的物理消耗。
2)三重专属Watchdog判定
· MemoryWatcher(内存看门狗):
- 当整树RSS达到配置上限的80%时,触发guard_alarm告警;
- 当超过100%时,启动宽限期倒计时(Grace Duration,默认60s);
- 若在宽限期内内存由于任务执行完毕释放回落至80%以下,看门狗具备去抖与自动恢复(De-jitter Reset)机制,重置告警状态;若宽限期结束依然超限,立即执行熔断(guard_kill)。
· ProcessCountWatcher(进程数看门狗):
- 实时统计整树进程数量。一旦超过MaxProcesses(默认200),判定为失控派生或Fork炸弹,直接熔断,不留宽限期。
· IdleWatcher(空闲卡死看门狗):
- 追踪任务最后一次产出有效ToolCall或协议消息的时间戳。在任务并发执行中工具数为0且静默时间超过IdleTimeout时自动回收,释放并发插槽。
3)结构化审计与可观测性
所有告警与熔断动作均被持久化记录为结构化审计事件,并通过CLI提供了开箱即用的诊断能力:
# 查看指定 Runtime 当前生效的配置与级联来源解释mopheus runtime guard explain <runtime-id># 查询最近的守卫熔断与告警事件mopheus runtime guard stats --workspace-id <ws-id>
Phase 2:Linux cgroup v2委托与四级配置级联
Phase 1解决了度量问题,但在极端场景下,基于procfs扫描和发送SIGKILL存在固有的“竞态窗口”:如果某个失控程序正在以极高速度fork(),向旧PID发送信号时,新子进程可能已经逃逸并被PID 1收养。
为了实现更加可靠的物理进程树隔离与生命周期管理,Phase 2将底层执行引擎迁移到了现代Linux cgroup v2。
1)Rootless User-Mode Systemd委托机制
在生产环境中,Mopheus Daemon通常以非Root普通用户(如mopheus-dev)运行。为了在无特权条件下使用cgroup v2,我们实现了基于Systemd User Slice的委托路径:
systemd-run --user --scope --slice=mopheus-tasks.slice \--property="Delegate=yes" \claude --input-format stream-json ...
· Daemon启动任务时,自动在/sys/fs/cgroup/user.slice/user-<uid>.slice/...下为每一个智能体任务创建独立的叶子节点;
· 任务执行产生的所有子进程、孙子进程无论如何派生,内核都会将其纳入同一个cgroup内部进行统一跟踪。
2)cgroup.kill:内核级原子整树销毁
当触发guard_kill时,Daemon不再遍历PID列表,而是直接向内核对应的控制文件写入:
echo 1 > sys/fs/cgroup/user.slice/.../mopheus-task-<task-id>/cgroup.kill内核会在底层原子性地冻结并终结该cgroup内的每一个进程,有效解决了传统方案中多级孤儿进程逃逸与残留的顽疾。
3)四级配置级联与约束合并
在Phase 2的重构中,我们标准化了配置合并逻辑,解决了“部分结构体覆盖导致零值清空”以及“单任务配置超过宿主机总预算”等边界缺陷:
// 强约束:单任务内存上限绝不能超过 Runtime 宿主机的总物理预算effectiveLimit := cfg.PerTaskRSSBytesif cfg.RuntimeTotalRSSBytes > 0 && effectiveLimit > cfg.RuntimeTotalRSSBytes {effectiveLimit = cfg.RuntimeTotalRSSBytes}
Phase 3:终态峰值画像与面向Agent的可观测性数据供给
Phase 1与Phase 2建立了稳固的防御网,但摆在工程团队面前的下一个挑战是:如何为不同类型的智能体与工作区设定最合理的物理资源预算?
设得过紧,正常的编译或大数据处理会被误杀;设得过松,又起不到防爆效果。此外,2秒一次的周期性采样虽然轻量,但可能错过亚秒级的瞬间突发峰值(Sub-second Burst Spikes)。
Phase 3聚焦于硬件级峰值画像(Hardware Peak Profiling)与面向AI Agent的可观测性数据供给(Agent-First Observability):
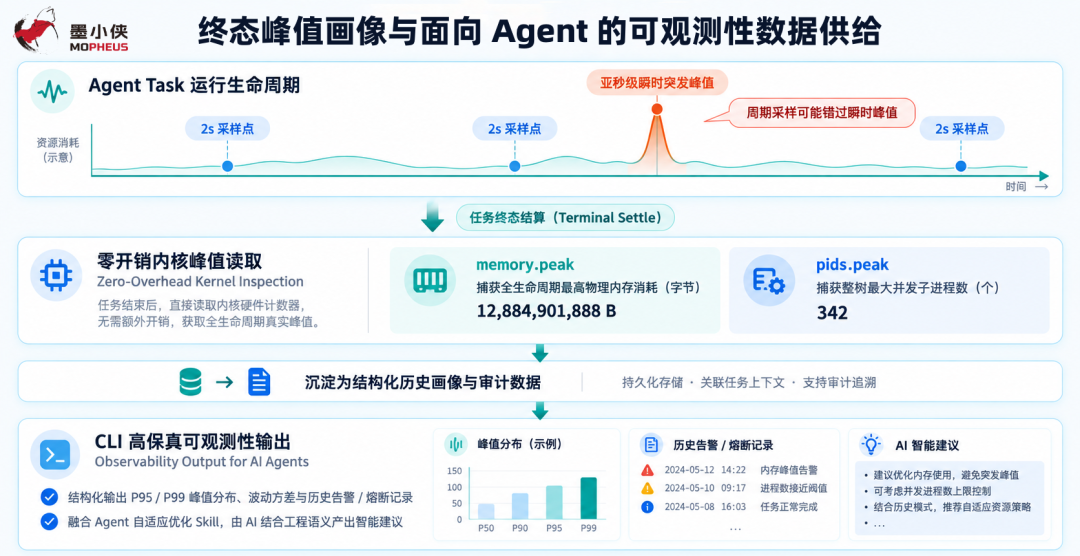
图4:硬件级峰值画像与面向Agent的可观测性数据供给
1)内核级零开销峰值捕获
在任务完成或终态结算(finalizeProviderResult)时,Daemon直接从cgroup控制器读取两个只读内核文件:
· /sys/fs/cgroup/.../memory.peak:记录该cgroup历史上达到的最高物理内存用量;
· /sys/fs/cgroup/.../pids.peak:记录该cgroup历史上的最大进程并发数。
这使得Mopheus既保持了2秒采样的低CPU开销,又通过内核硬件计数器补齐了亚秒级瞬间突发峰值的盲区。
2)CLI 的职责定位:为AI Agent供给高保真可观测性数据
在设计自适应调优时,Mopheus坚决避免在CLI里硬编码如P95 * 1.25这类死板、缺乏弹性的简单算法。在AI-Native架构下:
· CLI的核心职责是“数据透出与结构化呈现”:将Daemon在物理机采集的高保真私域指标(硬件峰值、分布分位数、任务类型、告警频次)以结构化JSON/视图完整提供出来(mopheus runtime guard stats --output json);
· 将“智能决策”交还给AI Agent:工程团队通过编写专属的自适应调优Skill,由AI Agent调用CLI读取这些底层的可观测性数据,结合该工作区的工程场景(例如Next.js大前端构建 vs Python数据分析 vs 轻量级代码审查)进行语义级综合分析,给出具有可解释性、贴合实际工程诉求的阈值推荐建议。
Phase 4:多维系统治理与柔性压制展望
在完成了内存、进程数与终态画像后,Mopheus Runtime Guard将进一步扩展到CPU、磁盘I/O、内核压力(PSI)与柔性降级压制的完整治理矩阵。
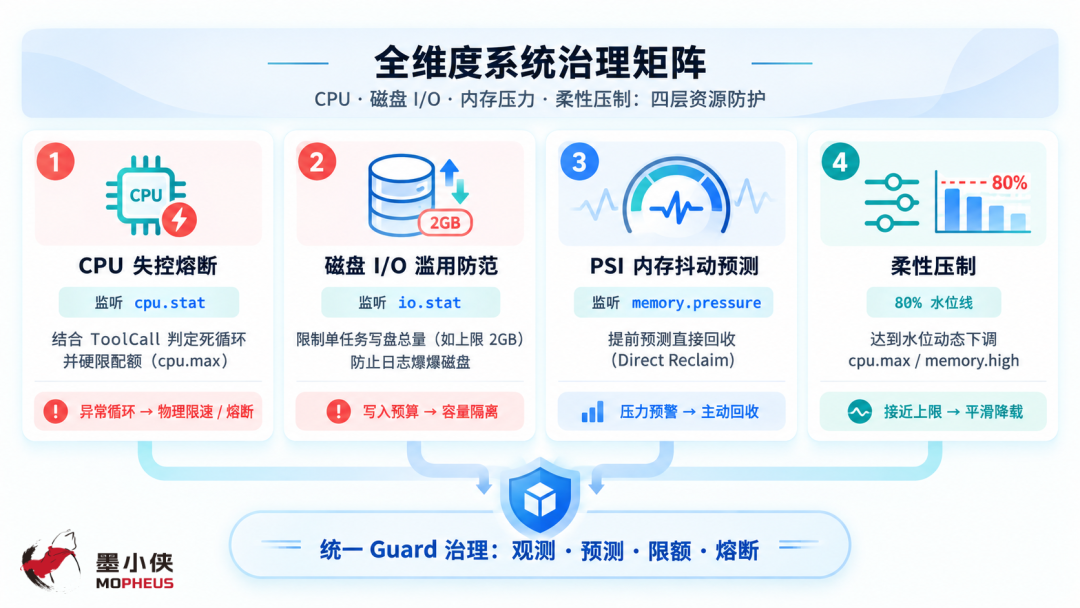
图5:Mopheus Runtime Guard的完整治理矩阵
1)CPU Runaway Guard(CPU失控熔断)
· 痛点:Agent生成的脚本陷入死循环(如while true),导致单核CPU 100%跑满数小时。
· 机制:采集cgroupcpu.stat中的usage_usec,计算单位时间内的CPU使用率;结合ToolCall静默状态,若持续5分钟占满CPU且无外部交互,自动介入并可配置cpu.max进行硬配额限制(如限制最多使用200%单核)。
2)Disk I/O Abuse Guard(磁盘I/O滥用防护)
· 痛点:异常脚本死循环打印超大日志文件,或错误解压超大压缩包,数分钟内填满宿主机硬盘。
· 机制:读取io.stat中的wbytes(写字节数)和wios(写IOPS),设定单任务写盘预算(如2GB);超出上限直接拦截写入并报警。
3)PSI 内存抖动预测(Pressure Stall Information)
· 痛点:有时候系统尚未触及OOM阈值,但由于内存紧张,内核频繁进入直接内存回收(Direct Reclaim)或剧烈Swap,导致整台宿主机出现严重卡死(Thrashing)。
· 机制:监控/sys/fs/cgroup/.../memory.pressure中的some avg10指标。当系统处于严重内存等待状态(如超过40%时间停滞)时,提前触发防护,先于系统级OOM介入处理。
4)柔性渐进式压制(Proactive Soft Throttling)
· 机制:告别“要么放任不管,要么立即SIGKILL”的二元论。当任务内存触及80%或CPU异常时:
1. 通过写入memory.high,让内核主动节流(Throttle)该任务的内存分配速率,强制其减速运行;
2. 动态降低cpu.max限制算力;
3. 观察任务能否在降速后自行收敛完成;仅在宽限期耗尽且持续超限时才执行物理cgroup.kill。
04收益与工程启示
在Mopheus研发团队坚持全面使用自身平台(Dogfooding)进行日常高强度开发与协作的过程中,我们面对了数次由于LLM推理与决策失控导致的进程树膨胀与物理内存突发飙升。正是这些最真实的生产工程摩擦,推动了我们系统性地思考、设计并落地了这套完整的运行时守护体系:
1.从“事后被动干预”到“确定性物理兜底”:通过cgroup v2与多维看门狗,Runtime Task Guard将偶发的失控行为隔离收敛在单个任务沙盒内部,有效防范了孤儿进程残留与宿主机物理资源耗尽的风险,保障了工程环境的稳定连续运行。
2.多租户精细化隔离:通过三态Feature Gate与四级级联配置,既允许研发与测试环境灵活探索,又保障了生产环境严苛的资源基线。
3.数据驱动的容量规划:借助内核级硬件峰值采集与面向Agent的结构化数据输出,工程团队与AI Agent能够依据真实的任务负载画像,做出最合理、最具可解释性的容量规划与动态调优。
真正的AI-Native协作平台,不仅需要让智能体“能做数据库运维、能写代码、能调工具”,更需要为它构建透明、可观测、有韧性的系统运行底座。
| 想让你的AI智能体在真实工程环境中 兼具执行效率与可靠的系统资源边界吗?立即上手探索Mopheus,为你的团队构建透明、可控、高可用的智能体协作工作空间!即刻访问mopheus.ai |