还要等多久?——极速恢复,守住业务连续性的最后一段路
01
09:17的告警:比故障更刺耳的,是那句“还要等多久”
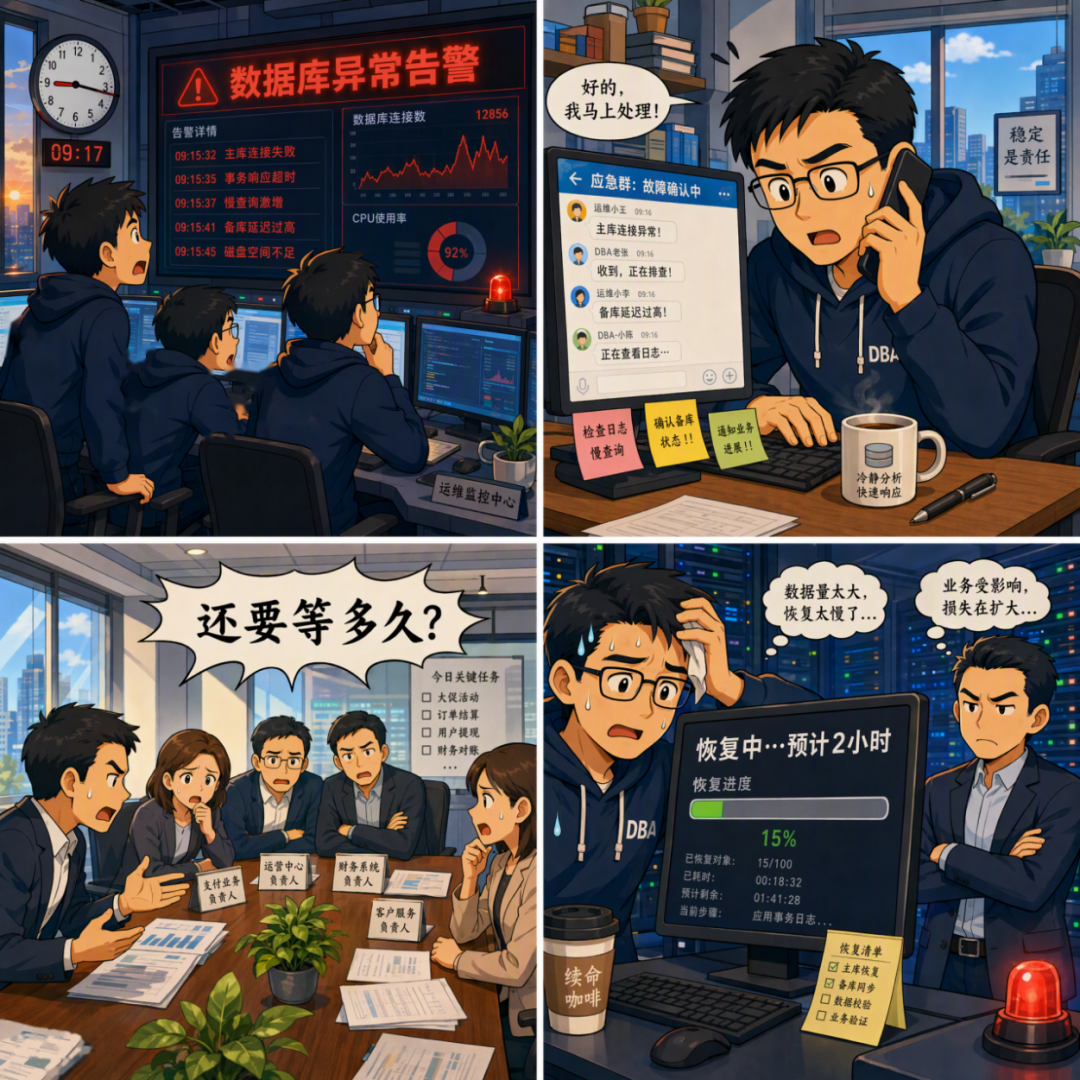
起初,没人把它当成是“大事故”。09:17,监控提示几张核心表更新异常;09:23,交易侧开始出现失败重试;09:31,DBA在变更记录里定位到一条误执行脚本。直到影响范围被确认,业务方、运维和值班领导才被拉进同一个应急会议。
大屏幕上是恢复日志,所有人的目光都落在DBA身上;焦灼地等待并追问:“业务恢复还要等多久?”
DBA先评估了对象级修复,又比对全库时间点恢复的影响范围:误操作牵连多个关键对象,现有方案无法在短时间内完成逐对象修复。“按全量恢复加归档日志应用走,乐观估计还要两个小时。”
同时,按预案对受影响对象先限写隔离;故障发生之后写入的待确认交易记录,留待恢复后补录、对账和回切评估。
故障最终被修复,业务也最终恢复。在事后的复盘会上,这次故障带来的损失被一笔一笔摊开:除了直接经济损失以外,更难量化、也更难修复的是客户信任、监管问责和商誉受损。
在这起事故中,灾备恢复方案看似完备。备份副本完整、归档日志齐全,恢复操作有预案流程可遵循,负责处置的DBA经验也足够丰富。可当问题真正发生时,一系列符合预案的操作,最终换来的却是业务难以承受的漫长等待。所以关键业务系统的灾备建设不能仅限于“能够恢复”,“多久能恢复”更应该成为一个被重点考量的因素。
●━━━━━━━━━━━━━━━●
02重塑共识:RPO被压低之后,RTO更应同步浮出水面
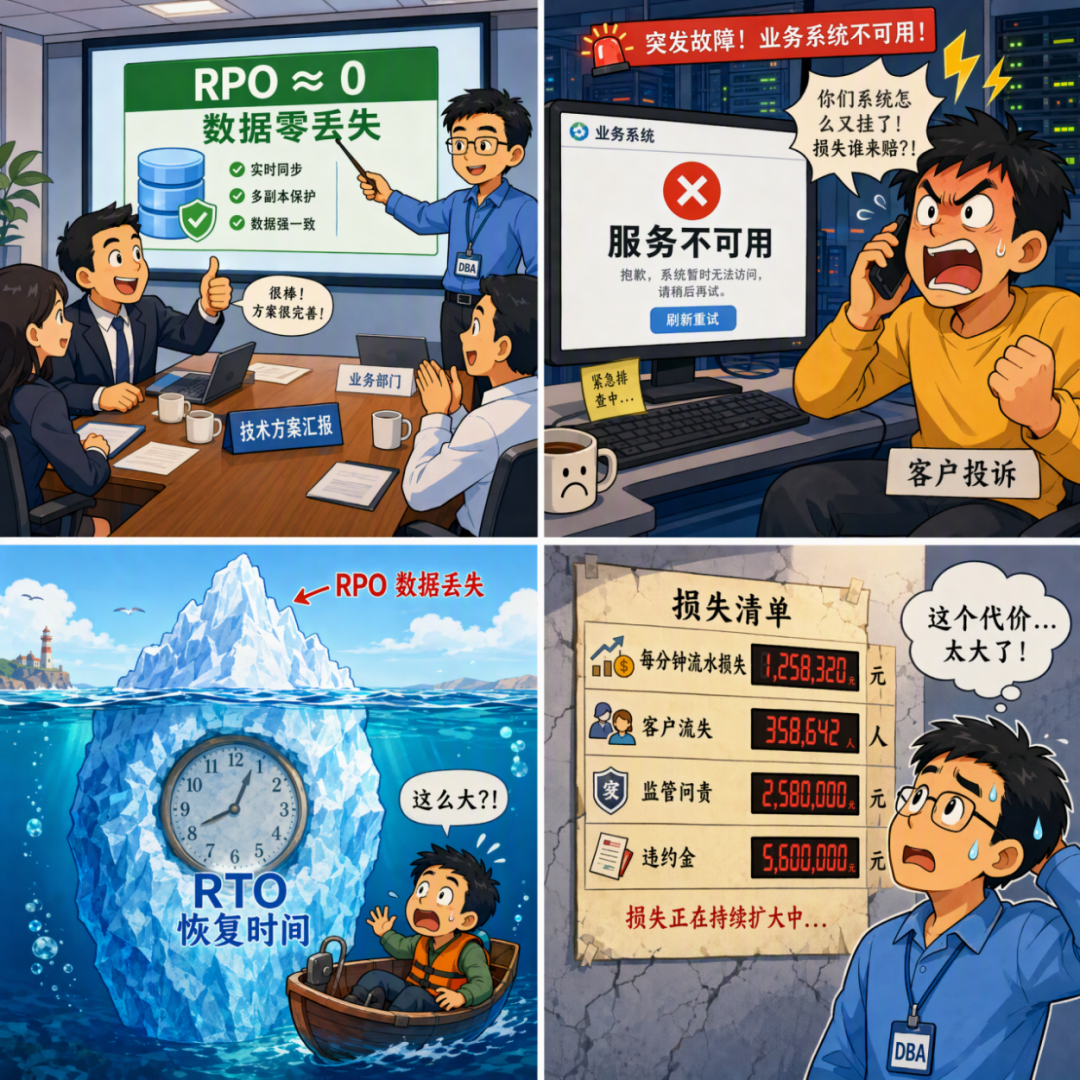
近几年,不少技术团队建设灾备系统,重心都放在降低RPO(恢复点目标)上,尽可能少丢数据。借助双活、ADG、持续日志保护等技术,数据丢失窗口已经从小时、分钟级别压缩至秒级,甚至近乎零丢失。于是很容易出现心理暗示:数据几乎不会丢,恢复流程也很完善,真出事时,业务自然可以顺利恢复。
这个判断只对了一半。在灾备系统建设时,RPO所定义的可容忍数据丢失量与RTO所定义的可容忍的业务中断时间同等重要,两者缺一不可。对于低RPO已得到保障的系统,灾备系统建设的重心往往会从“减少数据的丢失”转向“减少等待系统恢复的时间成本”。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
表1:RPO与RTO在不同维度上的对比
在IT系统安全面临的众多问题中,相比于硬件损坏带来的物理故障,更加棘手的是数据逻辑损坏类事故。数据还在,但不对;系统活着,但不敢用。物理故障可以通过数据库的主备倒换、存储的双活架构等系统的冗余设计快速恢复,甚至可以做到业务层无感知。数据逻辑问题仅靠硬件冗余无法解决,传统的恢复手段往往是小时级的耗时。
同样是恢复成功,小时级恢复和分钟级恢复对业务不是同一风险等级:前者把中断摊到客户、监管和舆情面前,后者才有机会把影响压缩在内部处置窗口内。
评价灾备能力,最终还是要回到业务中断时间。能恢复是及格线,可验证的快恢复,才更接近核心业务的生命线。
●━━━━━━━━━━━━━━━●
03传统恢复为什么偏慢?因为其恢复链路相当于“现场施工”
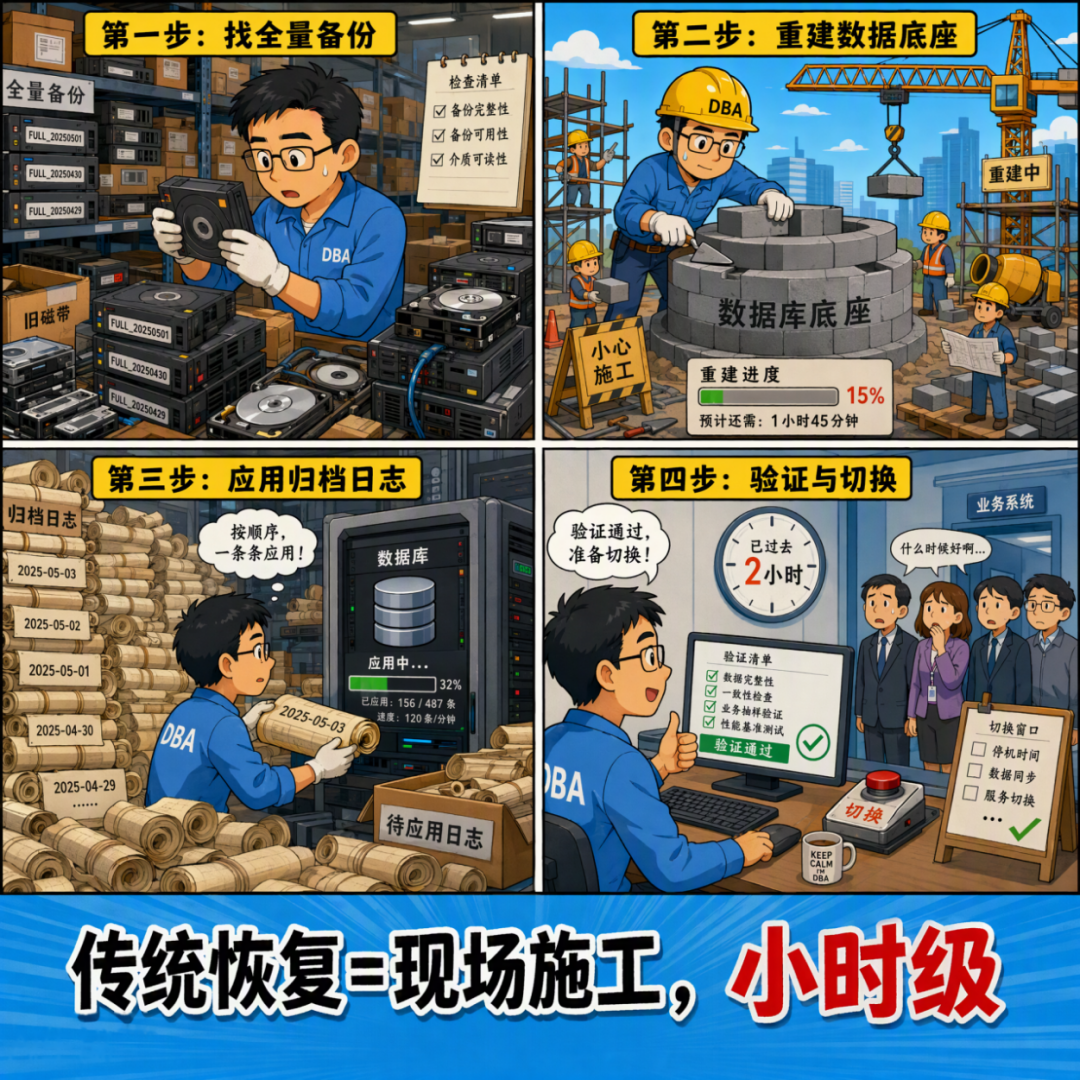
把以较早全量备份为起点的恢复链路拆开看,会发现一个共同点:它们更像“现场施工”,而不是“拎包入住”。
3.1 传统恢复的三段耗时
以全量备份为起点的恢复方案为例,数据库恢复链路通常可以拆成三段耗时:
数据库恢复链路耗时 ≈
数据底座重建时间+增量日志应用时间+验证与切换时间
注:端到端业务中断时间还包括故障发现、定位、处置决策、应用接入和业务确认。
● 数据底座重建:TB级数据文件要拷贝、还原。磁盘I/O、网络带宽和存储吞吐能力的约束摆在那里,这是硬耗时。
● 增量日志应用:传统PITR的重放量,取决于起点数据底座到目标恢复点之间隔了多久。以较早备份点为起点时,需要重放的归档日志通常更多,耗时往往随日志量增加,同时也受吞吐、并行度和增量备份策略影响。
● 验证与切换:恢复出来的库能不能直接接业务?数据库一致性校验、关键业务数据核验、应用连接、权限配置、缓存预热、灰度放通,每一步都要时间。
换句话说,房子塌了一角,传统方案常常是原地备料、砌墙、验收;而业务真正想要的是,旁边已经有一套可住的房子,最好还能先搬进去,再慢慢处理废墟。
3.2 另一个隐性成本:人的迟疑
还有一类成本很少被纳入业务恢复成本:DBA的决策迟疑。
恢复链路越复杂、耗时越长、操作越不可逆,值班人员就越倾向于反复确认。当业务高峰临近时,巨大的压力下人的判断力、决策能力都将受到严重影响。一想到“如果操作错误,业务恢复时间将变得更加不可控”,每一步决策和操作都会被拉长。这部分延迟是风险结构问题。好的灾备方案应当尽可能减少人在高压下做高难度判断,简化操作难度才能让业务恢复更加顺畅。
●━━━━━━━━━━━━━━━●
04极速恢复的关键:把大量耗时前移,把临场动作变少
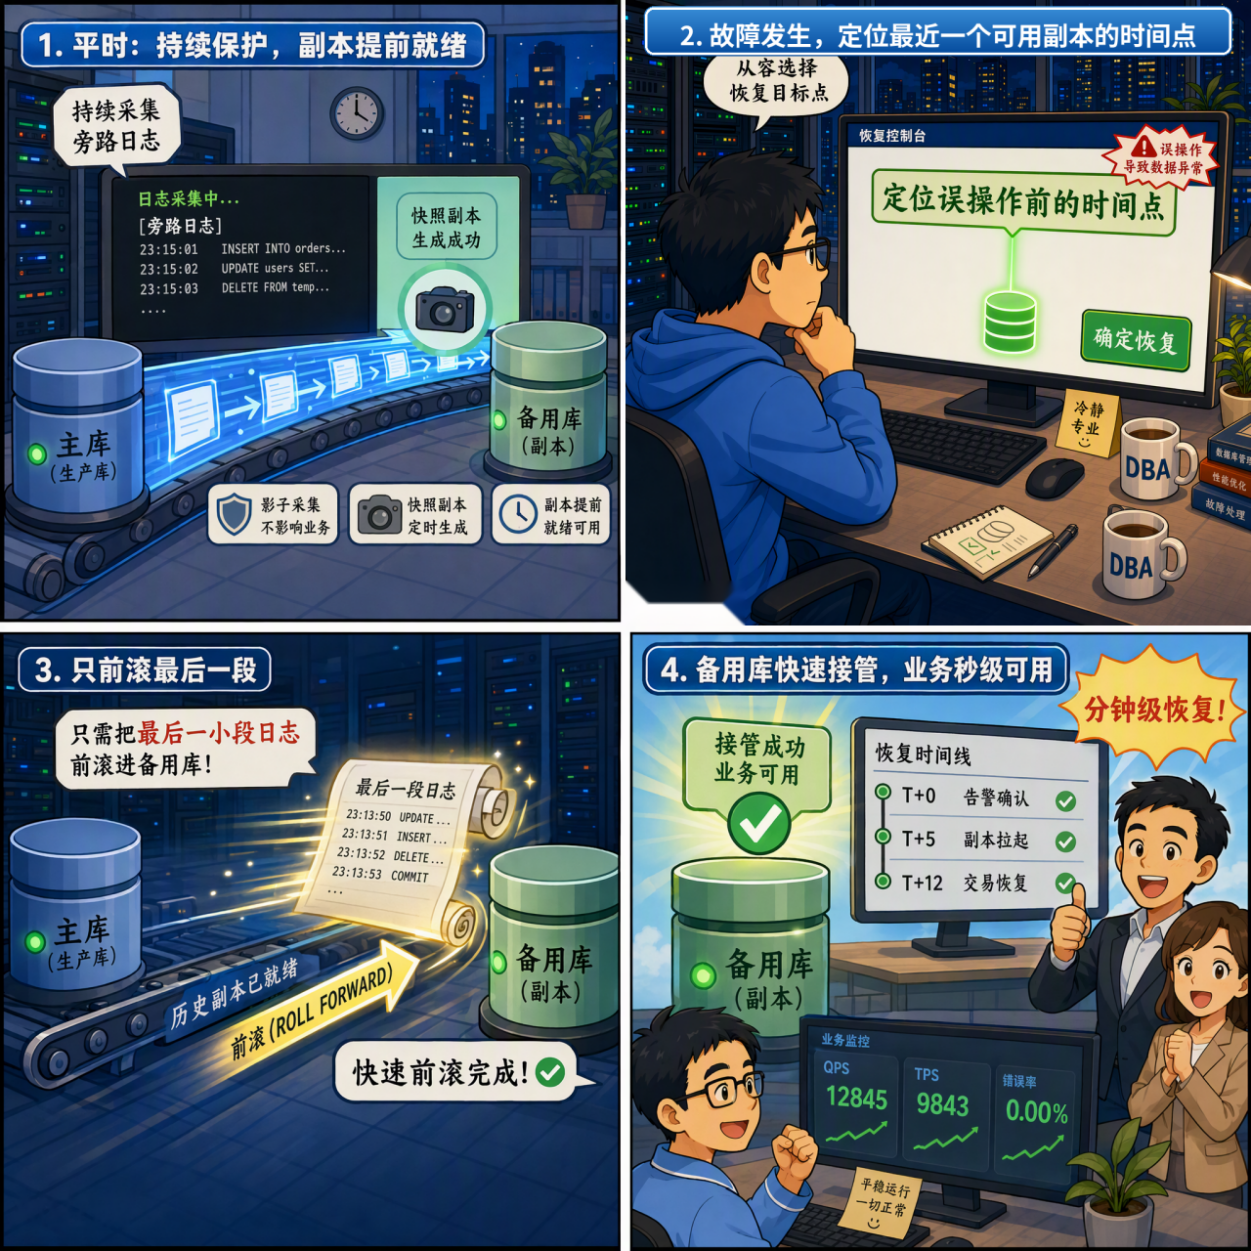
面向业务的极速恢复应该尽量做到一件事:数据底座提前就位,恢复时只应用最近可恢复快照之后、目标恢复点之前的增量日志;评估故障发生之后的有效交易,并提前准备补录、对账和回切方案。分钟级恢复得以成立的前提条件是:旁路日志连续有效、副本资源已预置、副本库的有效性已经过实时验证;连接字符串、权限设置、灰度切换经过演练。
这正是云和恩墨zData S持续保护平台的设计思路。上一篇我们讲过它如何用旁路日志应对逻辑损坏;本文接着展开另一半:在“找得回”的基础上,怎样做到“起得快”。
4.1 数据底座提前就位
zData S在持续采集旁路日志的同时,在保护端应用日志并生成副本,再通过高频快照固化多个时间点的数据库状态,让副本库随时处于“就绪”状态。
这里所谓“就绪”,应区分技术就绪和业务可用。日志链连续、事务边界完整、副本可被拉起并通过数据库级校验,只说明具备技术可恢复性;对于日志链路中断、源库时间异常、不可解析变更等极端情况,灾备系统应通过告警和降级策略显式暴露风险,而不是默认任何时点都可恢复。
满足技术条件后,可以生成误操作发生前的候选恢复副本;副本能否接管业务,仍需完成关键业务数据校验。传统恢复里最重的数据底座重建时间,才能在灾备恢复的实操作业中前移甚至消除。
4.2 只前滚最后一段
有了可用底座,先选择目标恢复点之前最近一份经验证可恢复的快照,再将连续的增量日志前滚至目标恢复点。目标恢复点须经核验,确保不包含首笔错误事务。以较早全量备份为起点的传统PITR,可能要重放备份之后、误操作之前的大量归档;而持续保护模式下,通常只需要处理“最近一次固化点之后、目标时间点之前”的一段增量。
需要临场补的增量数据越少,恢复越快。但前滚不能无差别应用故障点后的全部日志,必须先确认首笔错误事务发生前、经核验无错的目标恢复时间点或SCN,并识别该目标点之后的有效交易;否则可能再次带入错误操作。故障发生时间点不能只看告警或故障发生时间,而应结合审计日志、旁路日志、应用流水号和关键表变更比对圈定误操作窗口;窗口之后的写入,应按对象、事务来源和业务流水标记为待确认交易,恢复后进入补录与对账流程,而不是直接丢弃。
4.3 回到那个故障处置现场,如果重来一次……
以下为模拟时间线。
⏱ TIMELINE
事故发生 5 分钟告警确认并定位误操作窗口。
事故发生 7 分钟定位经确认的安全时间点,创建候选恢复副本。
事故发生 9 分钟副本创建完成,开始拉起备用数据库。
事故发生 12 分钟备用数据库可连接,应用组确认连接串、权限和白名单。
事故发生 15 分钟数据库级校验与关键业务数据核验通过,核心链路开始灰度切换。
事故发生 17 分钟灰度验证通过,交易恢复。
事故发生 19 分钟确认新库接管后的有效交易补录与对账,以及后续回切方案。
表2:模拟时间线(事故发生后分钟数)
从告警确认到交易恢复,平台处置耗时约12分钟;其中数据库副本创建与拉起约5分钟,其余为应用接入、核验与灰度放通。若计入故障发现、定位与人工确认,端到端中断可能会更长。但总体上故障处置恢复时间从小时级降低到分钟级。复盘时再看,这一次因业务中断带来的损失停在了一个可控的量级上。
●━━━━━━━━━━━━━━━●
05RTO不只是技术指标,更是经营指标
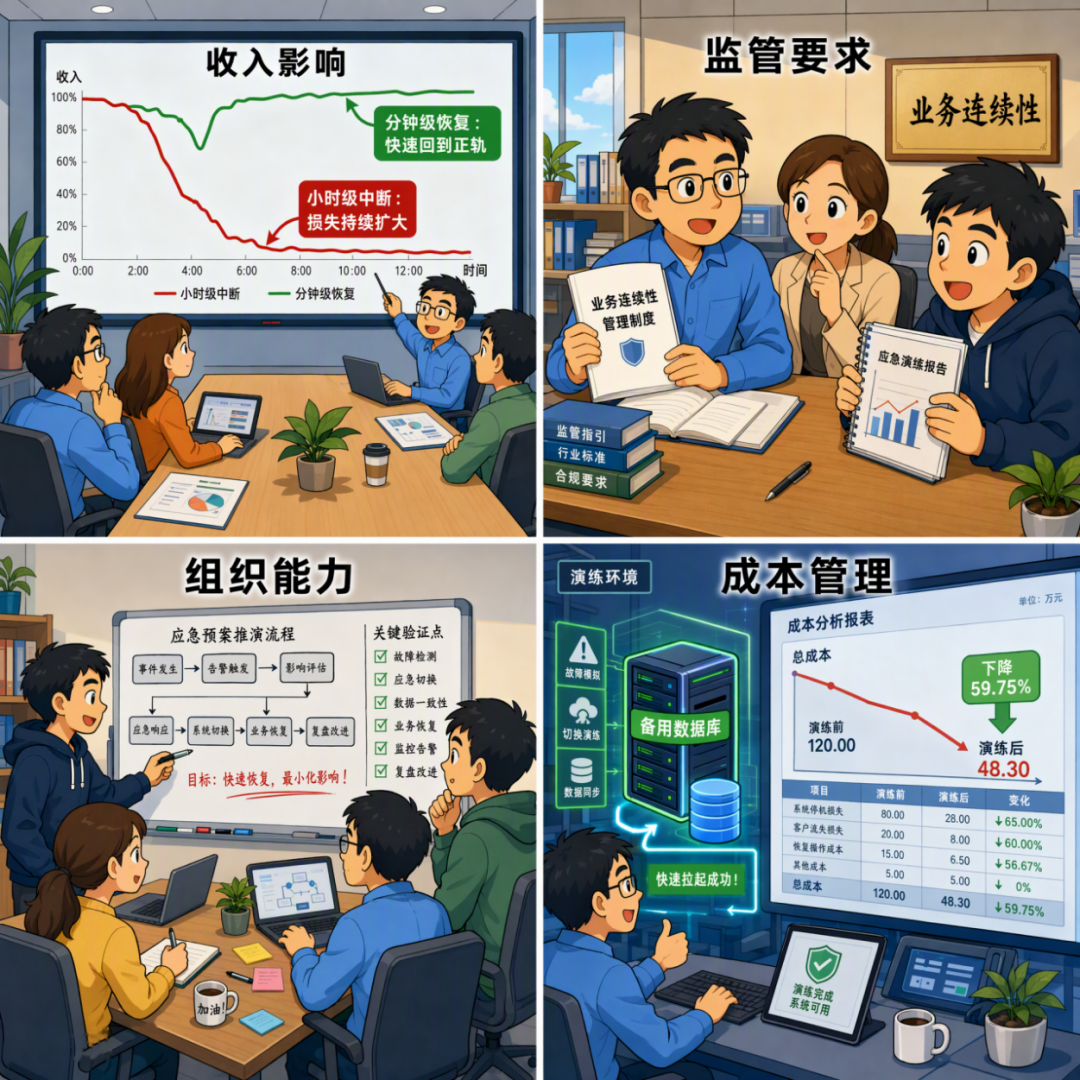
从业务经营的视角,“恢复处置降到分钟级”翻译过来,通常是四件事:
从四个视角看RTO的“经营价值”
① 收入影响:恢复处置从按小时放大损失,变成在分钟级以内止血。
② 监管风险:以金融机构为例,监管对业务连续性目标、演练、接管与安全回切验证有明确要求;分钟级恢复能力的价值在于让演练结论更接近实战可用。
③ 组织能力:DBA团队可以从全员紧急救火,转向预案前置规划、快速处置与成功恢复、事后复盘优化。
④ 成本管理:传统的恢复演练并不要求每次中断生产;但如果缺少隔离演练环境,以及配套的自动化工具和可快速拉起的副本,完整演练可能占用较多人力与资源。副本若能在隔离环境中快速拉起并验证,可降低演练所需的时间和资源。敢常态化演练的灾备,才更接近真实灾备。
●━━━━━━━━━━━━━━━●
06尾声:灾难面前,业务只关心一个问题
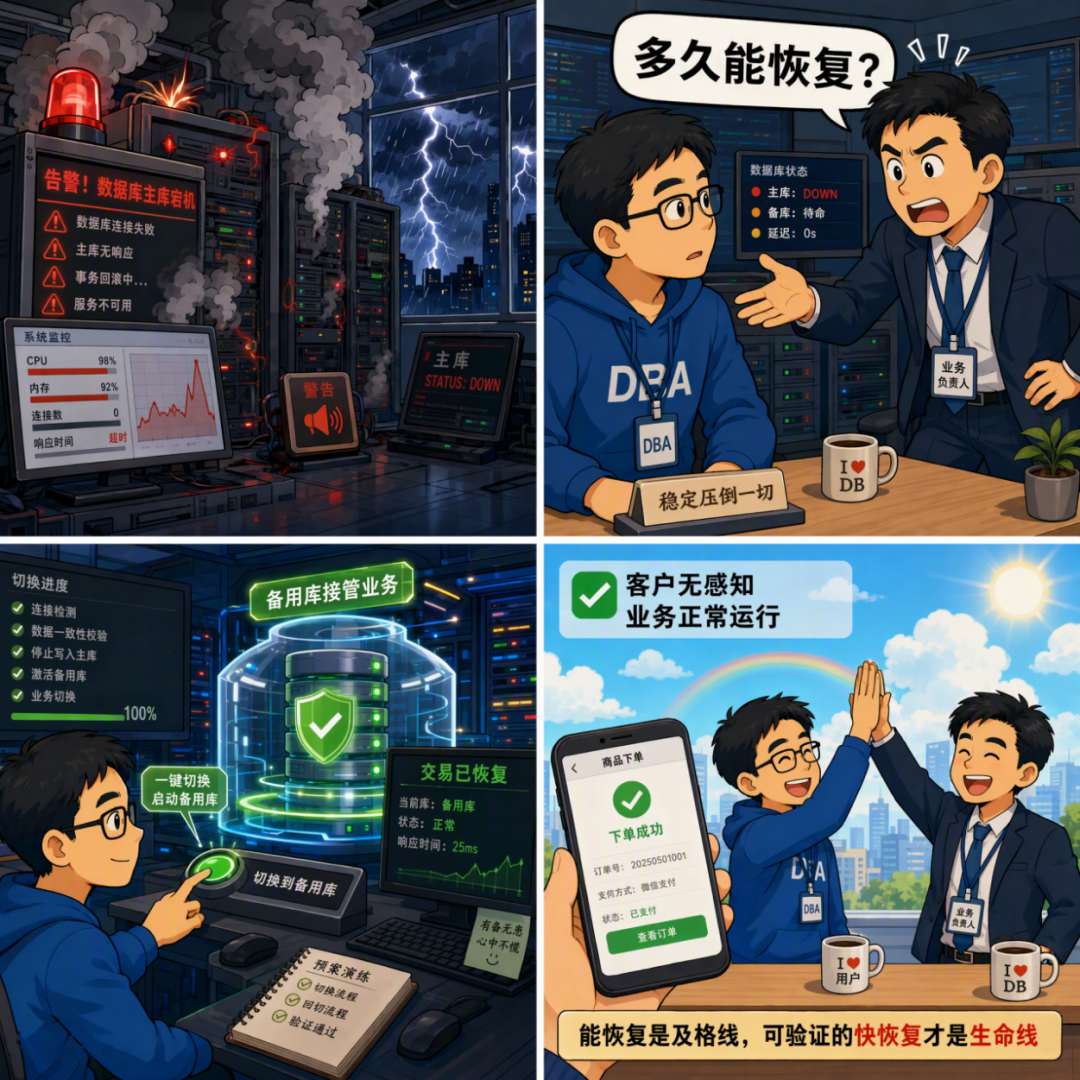
灾备能力的终极考题,不只是“能不能恢复”,而是“出事后,多久能恢复”。
数据保护行业花了很多年,把“丢多少”压到秒级;接下来应致力于把“停多久”压到可验证的分钟级,并让分钟级不是一次演示,而是可重复、可验证、可回切的能力。
| 极速恢复把“停多久”压到可验证的分钟级 让业务连续性真正可控了解zData S持续保护平台如何把数据底座前移、临场动作变少扫码添加云和恩墨小助手▼
|
 |