定时任务为何总变“黑盒”?我把例行周报统计从Hermes迁移至Mopheus的实战演练
在研发与运维团队的日常协作中,许多例行统计与数据同步工作往往被托付给自动化定时任务。随着大语言模型(LLM)能力的引入,通过自然语言智能体驱动的例行任务(如周报统计、工时汇总、告警巡检)变得越来越普及。
然而,在很长一段时间里,我的例行任务都部署在Hermes的定时任务调度中。随着运行周期拉长,一个日益严峻的问题逐渐显现:上游抖动导致的失败通知频繁刷屏,排查成本居高不下,而在失败重试机制下的Token账单也快速膨胀。
当团队接入Mopheus协作平台后,我选择将核心技能——周报统计mes-weekly-report作为首个试点迁移至Mopheus。本文将完整还原这次迁移的实操过程:剖析传统LLM定时任务的脆弱点、零代码改动的五步迁移路径,以及迁移后在系统稳定性、执行可观测性与成本控制上的实际收益。
01背景:传统LLM定时任务的“黑盒”困境
mes-weekly-report的核心逻辑并不复杂:按照固定的周期计划(Cron),从MES ITSM系统拉取工单与日志数据,执行聚合汇总与格式化,最终输出结构化的周报内容。理论上,这是一套全自动、无需人工干预的“数字员工”流水线。
但在长达数月的生产运行中,这套流水线的实际表现却充满波动:
1.失败通知频发:遇到网络抖动或上游限流时,任务直接中断,每周都需要人工介入排查与补跑。
2.重试成本高昂:传统调度在任务失败时往往采用粗暴的整任务重试,每次重试都需要重新将庞大的历史上下文载入模型,导致Token消耗成倍攀升。
3.状态黑盒与追踪困难:告警往往只显示“任务失败”,具体是卡在数据获取、格式转换还是模型推理阶段,必须登录宿主机翻阅混乱的日志文件。
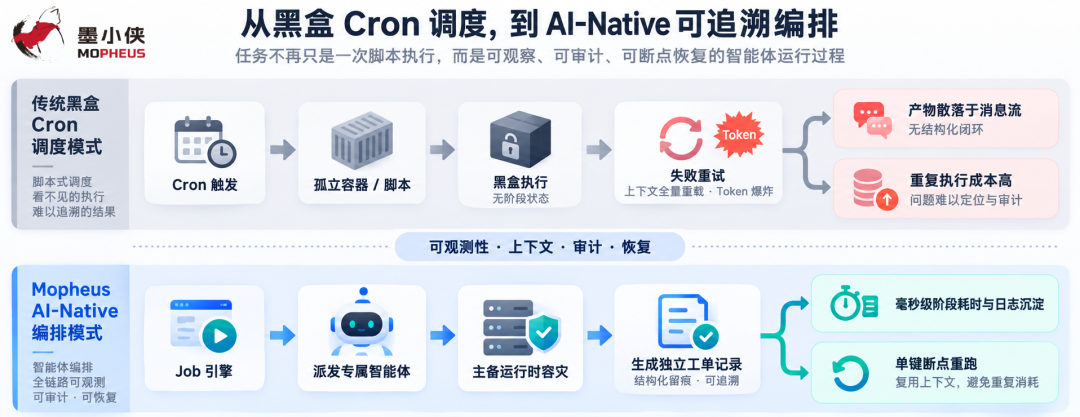
图1:传统黑盒Cron调度模式与Mopheus的AI-Native编排模式对比
●━━━━━━━━━━━━━━━●
02问题归因:例行智能体任务的四大系统性断点
为了彻底解决问题,我们必须先解构故障链路。分析历史日志可以发现,失败并非源于周报统计本身的业务逻辑漏洞,而是由基础设施与执行链路的脆弱性层层叠加导致的:
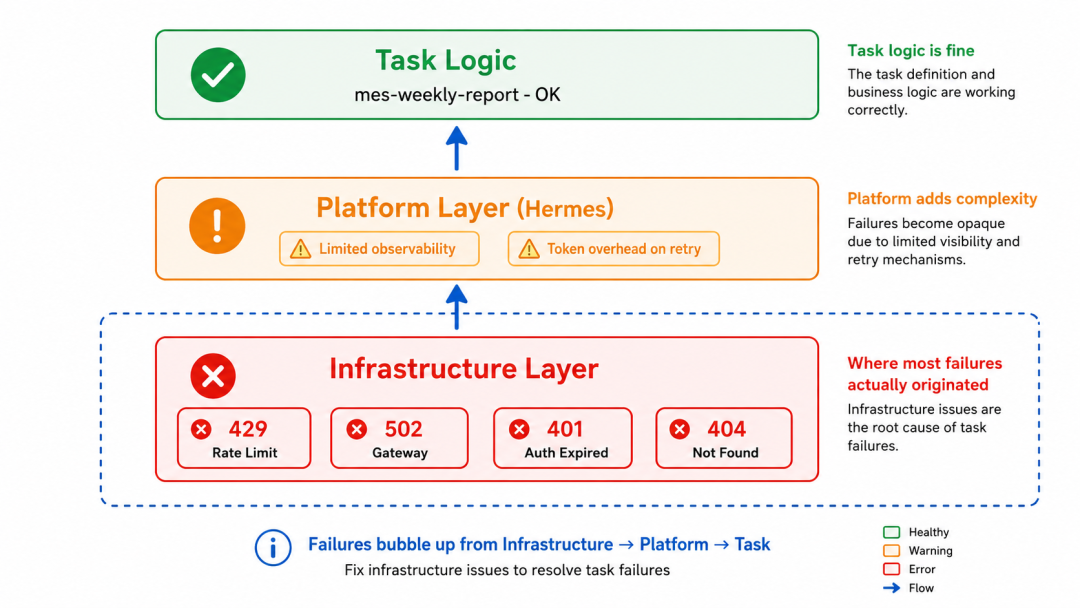
图2:定时任务失败的多层原因链路--任务逻辑正常,但基础设施层错误向上冒泡
这些系统性断点主要集中在四个维度:
1.并发潮汐与速率限制(HTTP 429):多项定时任务集中在整点触发,突发并发请求极易击穿上游API的Rate Limit阈值。
2.网关与依赖抖动(HTTP 500 / 502 / 503):微服务网关或第三方系统的瞬时异常直接向上冒泡,缺乏优雅的降级与缓冲机制。
3.鉴权状态漂移(HTTP 401 / 403):长期运行的Session Token或API Key过期,导致下游批量任务链式崩溃。
4.数据契约漂移(HTTP 404 / Schema Mismatch):上游返回结构发生微小变化,黑盒脚本解析失败后直接中断退出。
在传统黑盒式调度中,宿主机资源紧张、网关偶发抖动与凭证生命周期管理不当,最终都会直接转化为终端任务失败。要从根本上提高可靠性,关键在于解耦业务技能定义、引入高可用多运行时,并将执行过程转化为透明、可审计的工作流。
●━━━━━━━━━━━━━━━●
03为什么选择Mopheus:解耦、弹性和可追溯
选定Mopheus作为承载平台,核心在于其为AI时代设计的原生工作空间与智能体协同架构:
· 标准化的技能资产(Portable Skills):技能采用解耦的结构化规范(包含SKILL.md、可执行脚本与依赖资源),支持以标准Zip包在不同空间自由导入导出,无需修改底层业务代码。
· 主备运行时容灾机制(Primary & Fallback Runtimes):智能体支持同时配置首选模型运行时与备用Fallback运行时。当主模型接口遭遇限流(429)或不可用时,系统自动无缝切换,确保任务执行的连续性。
· 以工单为载体的价值沉淀(Ticket-based Traceability):Mopheus的Job引擎支持将任务动作(Action)配置为create_ticket。每次定时触发都会在工作空间中自动生成一条关联工单,产出物结构化沉淀,支持跨团队评审、追问与版本回溯。
· 全生命周期可观测性(Observability):每一次JobRun都有明确的状态机跟踪(Running、Completed、Failed、Skipped),精确记录各阶段耗时、模型交互细节与运行时日志。
●━━━━━━━━━━━━━━━●
04五步实战迁移:业务代码零侵入
整个迁移过程遵循“技能解耦打包 → 平台导入注册 → 智能体装配 → 任务编排 → 链路验证”的标准SOP,业务统计代码无需做出任何改动。
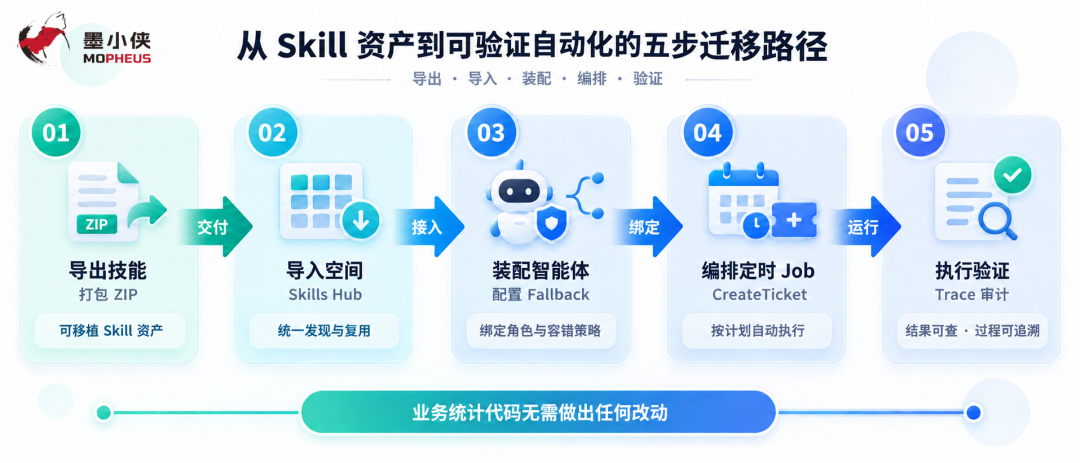
图3:五步实战迁移标准SOP流程示意
第一步:解耦导出技能包
在原环境中定位mes-weekly-report技能目录,确认其SKILL.md元数据定义、Python/Shell执行脚本以及相关依赖配置完整无误,打包为标准Zip格式。
第二步:导入Mopheus工作空间
进入Mopheus Web UI的「技能管理(Skills)」模块,点击导入并上传Zip包。导入完成后,技能即作为工作空间资产就绪,进入待装配状态。
第三步:创建专属智能体并配置Fallback运行时
在工作空间中创建名为“周报总结”的智能体:
1. 绑定技能:挂载刚导入的mes-weekly-report技能;
2. 配置运行时:选择主模型运行时,并配置高可用备用运行时(Fallback Runtime),以抵御上游模型API偶发超时或限流。
第四步:配置自动驾驶定时任务(Scheduled Job)
进入Mopheus的「定时任务(Jobs)」编排引擎,新建周期任务:
· 触发类型(Trigger):选择Schedule,配置标准的Cron表达式(如每周固定时间触发);
· 任务动作(Action):选择create_ticket(创建工单),指定执行者为刚创建的“周报总结”智能体;
· 配置目标(Goal):填入清晰的周报统计目标与交付要求,启用该任务。
第五步:手动触发与全链路验证
在正式切入生产调度前,在看板中执行一次手动触发(Manual Trigger),进行端到端审查:
1. 技能装载检查:核验智能体能否正确调用mes-weekly-report脚本;
2. 数据一致性验证:比对生成的统计口径与历史基准数据,确保逻辑一致;
3. 工单与日志流审计:检查生成的工单是否完整包含周报正文,并在Job执行记录中确认耗时与调用链正常。
●━━━━━━━━━━━━━━━●
05迁移效果复盘:从“被动救火”到“透明自愈”
迁移上线后,mes-weekly-report已在Mopheus上稳定运行数周。从日常运维角度来看,收益主要体现在以下几个方面:
需要客观说明的是,外部API的瞬时抖动或上游服务限制客观存在,任何平台都无法消除外部依赖的不确定性。但Mopheus带来的核心价值在于:消除了执行黑盒,让每次运行都有据可查,让偶发异常具备自愈与降级能力,从而将工程师从机械的日常盯盘与被动重试中彻底解放出来。
●━━━━━━━━━━━━━━━●
06总结与架构思考
智能体(Agent)从“实验性玩具”走向“企业级生产力”的分水岭,往往不在于Prompt编写得多精巧,而在于其底层的执行环境是否隔离可控、调度链路是否具备容灾弹性,以及产出物是否能够融入团队现有的工程工作流。
通过将周报统计从孤立的脚本调度迁移至Mopheus,我们不仅验证了技能模块(Skills)的高可移植性,更体验到了“智能体 + 定时Job + 工单闭环”所带来的工程确定性。对于团队中更多的例行数据分析、代码扫描和巡检任务而言,这种高可用、可追溯的AI-Native工作流正是演进的必然方向。
| 想让团队的日常例行任务与定时统计 告别脆弱与黑盒吗?立即上手探索Mopheus,为你的工作空间打造高可用、可追溯的智能体自动化工作流!即刻访问 mopheus.ai |