从事件风暴到因果收敛:Mopheus多智能体协同事件触发架构与防循环实践
在现代企业研发与生产运维(ITSM SRE)场景中,单次对话式的AI Chatbot已经无法满足复杂的工程协同需求。真正的价值在于让智能体(Agent)作为“数字协作者”,自主监听系统事件、并发会诊、交叉复核并输出专业报告。
然而,将事件驱动(Event-Driven)架构引入多智能体系统时,工程师面临一个极其致命的工程挑战:自激级联与无限死循环(Self-Feeding Infinite Cascades & Ping-Pong Loops)。
本文深入剖析Mopheus在实现事件驱动多智能体协同引擎时的架构演进历程,揭示我们如何通过因果祖先链(Causal Lineage)与全内存因果门禁,在保障多智能体深度协作的同时,实现O(1)的因果闭环收敛。
01根本思考:有了Team智能体团队,为何还要引入Event驱动?
在Mopheus的架构中,我们早已支持了Team(智能体团队)——用户可以通过配置Team Leader、成员专家(如架构师、编码员、测试员)以及工作指令,让一个团队自主拆解目标、向下派发Subagent并交付工单。
那么,一个很自然的技术疑问是:既然已经有了强大的Team机制,为什么还要耗费心力构建一套底层的Event事件驱动体系?
答案在于:集中式推式编排(Top-Down Orchestration)与响应式分布式编排(Reactive Choreography)在协作范式上的根本差异。
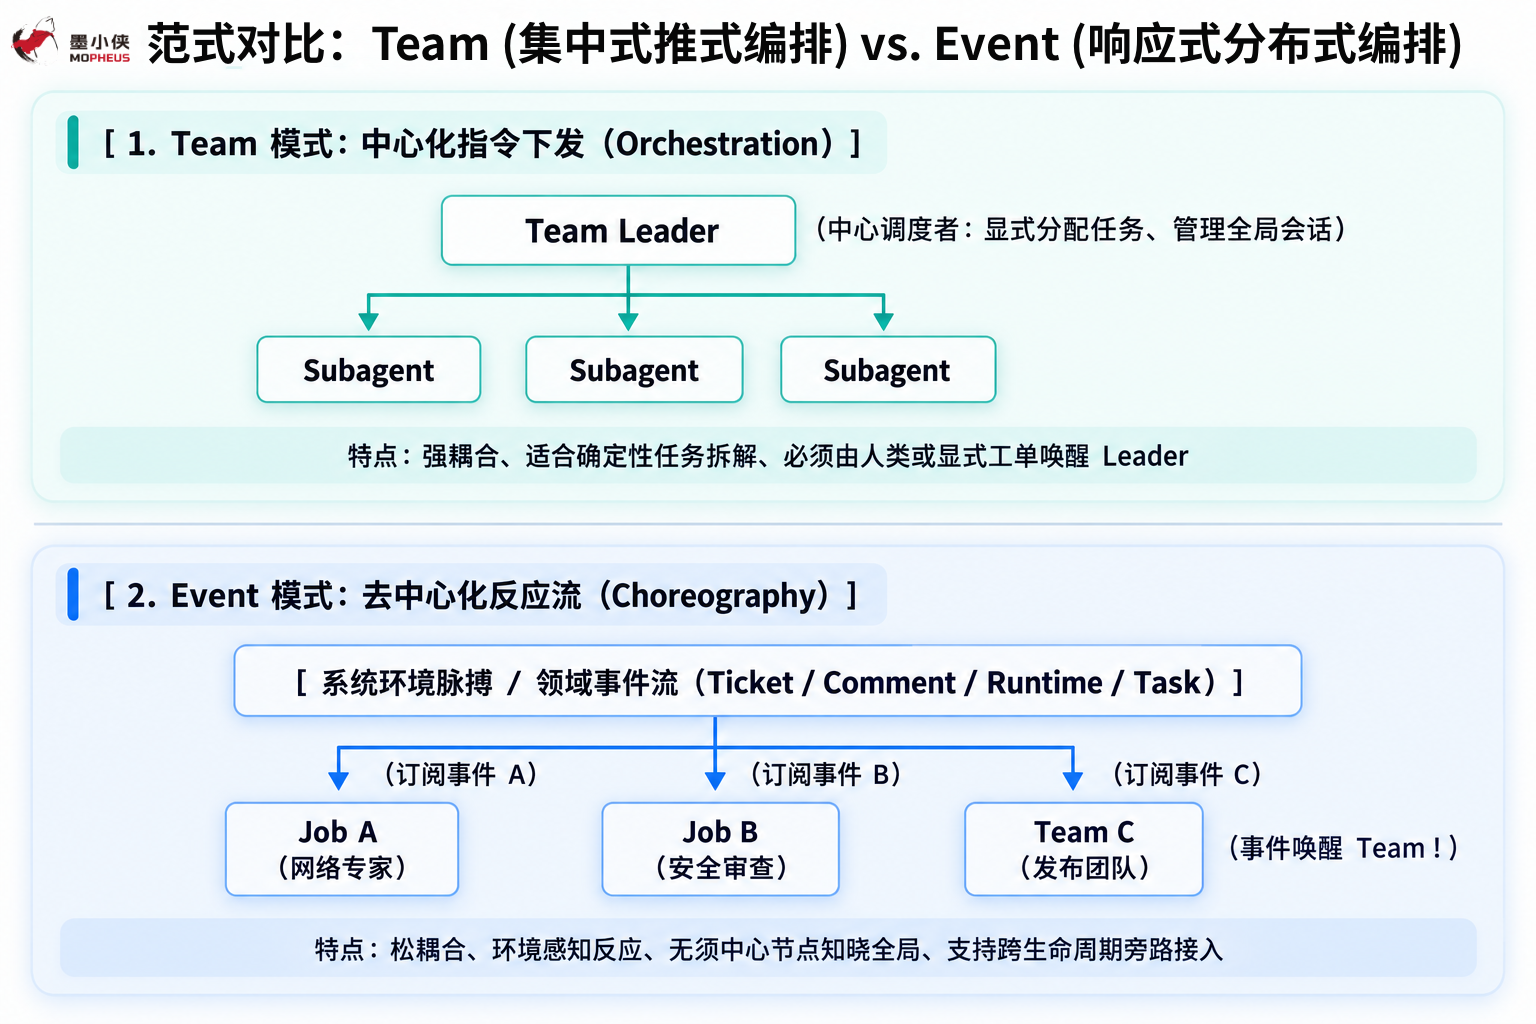
1.1 为什么需要Event?三种协作维度的深层对比
为理解引入Event的必要性,我们需要从执行时机、流程组织与系统扩展三个维度,对比纯Team模式与Event驱动模式的根本差异:
维度一:执行时机——从“被动拉起”到“主动感知”(Pull轮询 vs. Push广播)
-
Team本质是执行单元,必须被动拉起:无论是由人类分配工单,还是由定时任务(Cron)周期性触发,Team本身无法脱离外部指令而常驻感知环境;
-
定时任务(Pull)存在天然的时延与空转矛盾:如果依赖定时任务拉起Team,其实质是让Job周期性轮询数据库或外部接口(Pull)。但系统不可能以秒级高频去全库轮询,这必然带来数分钟乃至数小时的感知延迟与大量空转资源消耗;
-
从Webhook到内部Event:外部脉搏与内部脉搏的全域打通:
或许有了解Mopheus能力的读者会问:Mopheus不是早已支持了Webhook类型的Job吗?那同样能被外部事件唤醒呀!
确实,从设计哲学上讲,Webhook和内部Event本质上都是事件驱动(Push模式)。它们的核心区别在于感知的事件源头不同:
-
-
Webhook Job响应的是“Mopheus系统之外的外部世界脉搏”(如GitHub PR提交、外部监控告警、飞书群消息推送),让智能体能够响应外部异构系统的召唤(关于Webhook Job的深度设计与实战,我们将在后续专文中详细拆解);
-
内部Event则打通了“Mopheus原生协作生态的内生脉搏”(如工单状态流转、工单评论新建、Agent任务完成、Daemon节点心跳)。
-
内部Event触发器的落地,补齐了整个系统反应式感知中最关键的一块内生拼图——让智能体不仅能感知外部世界的指令,更能在系统内部的协同演变中自主联动,实现真正的毫秒级零等待(Zero Latency)与零空转开销(Zero Empty-Poll Overhead);
-
-
场景示例(记忆蒸馏):在没有内部Event时,只能靠人工点击或定时任务每隔数小时批量拉取完成的工单进行记忆提炼,导致新沉淀的经验严重滞后;有了内部Event后,工单一旦标记为Done,系统立刻自动派发针对该工单的蒸馏任务,使后续接力任务的智能体能及时检索到最新沉淀的经验。
维度二:流程组织 —— 从“预先规划”到“去中心化响应”(Pre-planned vs. Decentralized)
-
Team模式依赖严格的预设链路:Team运作的前提是必须事先规划好全流程(谁先执行、谁后接力、如何汇总、分支如何路由),高度依赖强计划性的中心化编排;
-
Event模式实现去中心化的敏捷协作:无需任何中心节点事先绘制全知全能的流程图。网络专家只监听故障工单,报告员只监听评论评论,各个角色平权自治,协作链随着系统事件流转自然发生并平稳收敛。
维度三:系统扩展——从“侵入业务”到“旁路解耦”(即插即用的全局治理)
-
在仅有Team的模式下:诸如“全局合规审计”“代码安全巡检”“工单完成自动归档”等横向治理逻辑,必须强行写入每个业务Team的日常指令中,侵入性极强且极难统一维护;
-
在Event驱动模式下:全局治理需求被抽离为独立的旁路Job。业务Team专注做业务,旁路Job专注做治理,随时可以即插即用地上线新策略,对现有业务团队零修改、零干扰。
1.2 完整形态:宏观Event编排 + 微观Team攻坚
在Mopheus中,Team与Event绝非互斥关系,而是形成了“1+1>2”的完整协同:
-
宏观层面由Event负责连接:系统事件发生 → 触发器自动匹配 → 将任务或工单动态指派给最合适的角色;
-
微观层面由Team负责深耕:当Event唤醒的是一个Team时,Team Leader带领其架构师、研发与测试智能体,在团队上下文内完成多角色复杂推理与交付。
Event是分布式协同的“神经系统”,Team是集中式执行的“作战小队”——两者的结合,才构成了真正完备的AI原生自动化工作区。
●━━━━━━━━━━━━━━━●
02核心工程痛点:多智能体系统的“事件风暴”
在建立了事件驱动体系后,我们希望在典型的事故响应流程中建立如下自动化协作链路:
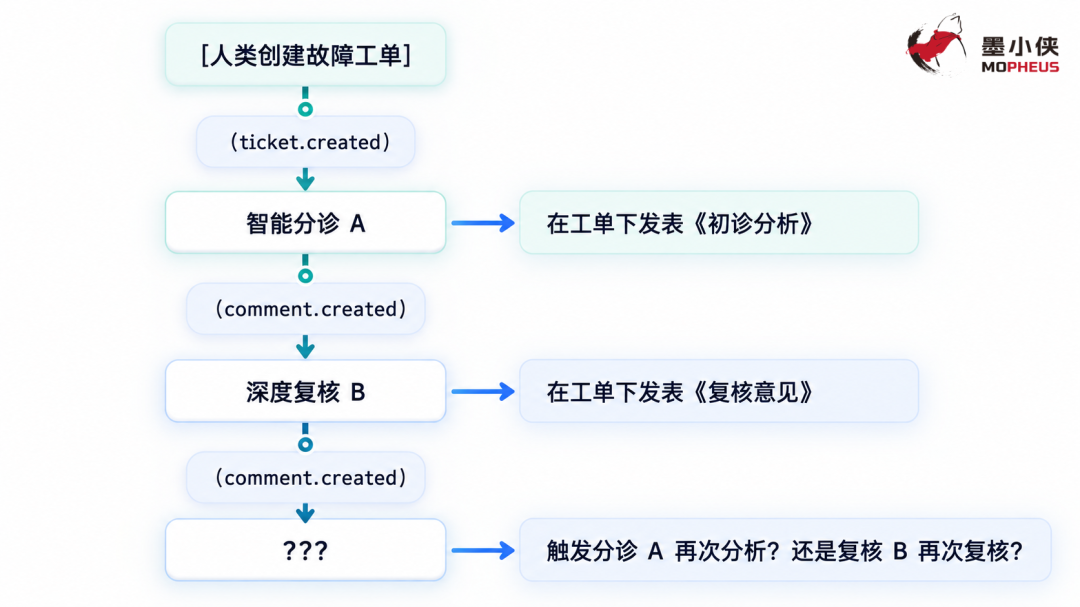
图中的???正是多智能体事件驱动系统的核心痛点:智能体既是事件的消费者,又是新事件的生产者。当智能体因响应事件而产生业务操作(如评论、修改状态、衍生子任务)时,这些操作会作为新事件被再次广播出去,导致系统极易陷入死循环:
1.直接自激循环(Direct Self-Loop):智能体A监听评论事件,其评论动作本身又广播了评论事件,导致智能体A被自己无限唤醒(A → A → A);
2.多跳乒乓循环(Ping-Pong Indirect Loop):智能体A的评论触发了智能体B,智能体B的复核评论又重新触发了智能体A(A → B → A → B);
3.传统粗暴防循环方案的局限:
-
按智能体身份一刀切(Ignore Agent Events):如果简单规定“只要是智能体产生的数据一律不触发任何Job”,虽然避免了死循环,但同时也彻底抹杀了多智能体链式协作的能力(例如:智能体A诊断产生的分析报告,就无法再自动触发智能体B展开针对性复核);
-
单跳反查(Parent Lookup):若仅比对直接父级工单或任务ID,无法识别经过2跳以上的间接回环(A → B → C → A);
-
全局限流与计数器(Rate Limit Max Runs):属于粗粒度的破坏性兜底,无法区分正常的高并发业务与失控死循环,容易留下半途而废的悬空任务。
●━━━━━━━━━━━━━━━●
03架构解法:全内存因果祖先链(Causal Lineage)
面对这种死循环,在进入Mopheus的解法前,我们先回答一个关键工程问题:为什么传统系统常用的“查库反查关联关系”在多智能体高频事件流下不可行?
3.1 传统直觉做法与瓶颈:依赖“数据库关系反查”
在传统的后端设计中,当系统接收到一个新事件(例如“工单新增了一条评论”)时,为了判断“这条评论是不是某个Job自己发出的下游产物”,最直觉的做法是到数据库中追溯实体的血缘关联关系:
1.拿着comment_id去查数据库,找出发表该评论的agent_task_id;
2.查agent_task表找出其所属的job_run_id和对应job_id;
3.如果涉及多跳调用(A触发B,B触发C),还需要递归往上反查整棵父级任务关联树。
这种“事后查库反查”有三个致命缺陷:
-
I/O性能与吞吐瓶颈:每一次高频事件到达,都要在调度前进行多次递归SQL查询,在高吞吐的事件风暴中,数据库连接池和I/O会瞬间被打满;
-
异步竞态与状态不一致:在极度异步的多智能体并发中,事件可能在数据库事务尚未完全提交或异步任务状态落库前就已经被广播出去,导致查库反查落空,产生漏判而误触发死循环;
-
复杂度随链路加深线性膨胀:调用链路每多一跳,反查SQL就多一层递归,系统开销无法预测。
3.2 Mopheus的解法:带状态传播的“因果祖先链”(Causal Lineage)
既然“事后去数据库反查关系”既昂贵又不可靠,Mopheus换了一个思路:不在事后查库,而在事件流转时将因果关系像DNA一样随身携带在事件载荷中。
每个由Job派发的智能体任务(agent_task)在其运行上下文(context)中维护一个只增的祖先Job ID列表:
{"eventType": "comment","eventAction": "created","ancestorJobIds": ["264aa8e0-9954-4288-84ad-2150972d2cca","1964ab2a-e803-4be9-832d-cc6c50e24058"]}
3.3 运行时传播与全内存门禁算法
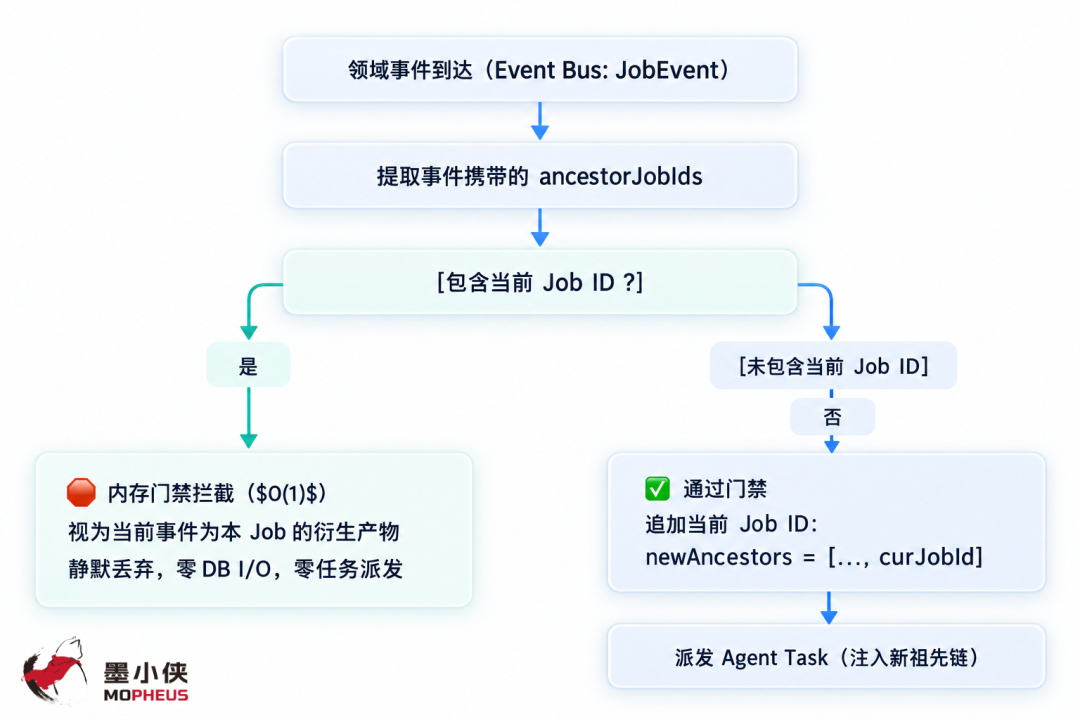
算法细节:
1.身份透传:智能体执行时,Daemon通过携带agent_task_id的专属API Token与服务端交互,所有由该智能体产生的工单、评论、状态变更均自动绑定该任务的上下文;
2.事件广播:当领域事件(如comment.created)发出时,事件载荷携带当前任务的完整ancestorJobIds;
3.全内存门禁:在server/internal/service/job_event.go中,引擎在派发前检查:
if slices.Contains(eventAncestors, currentJobID) {// 命中了自身祖先链,证明当前事件是自身历史上游衍生的,立即阻断continue}
4.祖先追加:若门禁通过,将currentJobID追加至切片尾部,传递给新派发的下游任务。
该设计实现了零数据库查询、零分布式锁,单次判定仅耗时数纳秒,且能天然阻断任意N跳的有向图环路。
●━━━━━━━━━━━━━━━●
04解耦设计:Pub/Sub广播与Service层极速求值
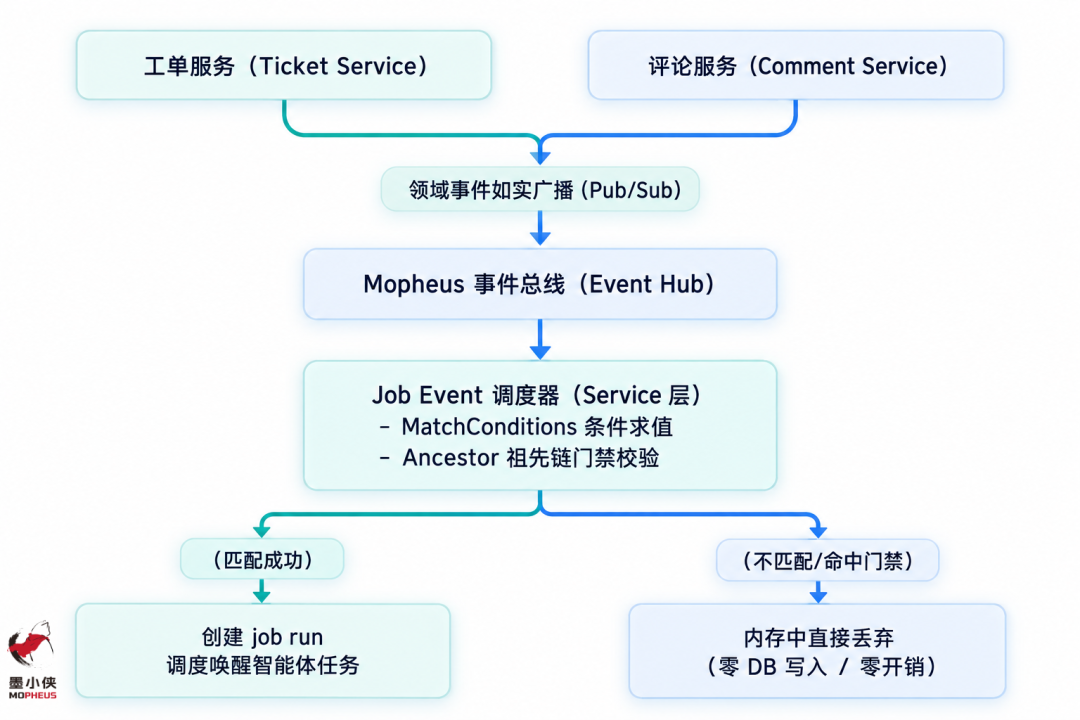
在事件驱动架构中,另一个关键考量是生产者与消费者的解耦:
-
生产者零逻辑污染:工单与评论模块只负责如实发布领域事件,对下游存在哪些Job、有哪些复杂过滤规则一无所知;
-
极速前置过滤:Job配置的
conditions(例如priority == "urgent"、status == [2, 3])在Service内存层进行字段求值,未命中的事件在微秒级内直接忽略,不会产生无效的数据库写入与智能体唤醒。
●━━━━━━━━━━━━━━━●
05生产级场景:SRE重大事故多专家协同演练
为了全面验证这一架构的可靠性,我们在Mopheus靶场中搭建了一个生产级重大故障协同排查场景:
5.1 团队角色与Job配置
-
网络专家(
NetOps-Expert):由Job-NetOps驱动,仅监听priority == "urgent"的工单创建事件,负责网络与网关排查; -
存储专家(
Storage-Expert):由Job-Storage驱动,仅监听priority == "urgent"的工单创建事件,负责数据库与IOPS排查; -
应急报告员(
Incident-Reporter):由Job-Reporter驱动,监听工单下的评论创建事件,负责工单全局评论汇总与全量定性通报。
5.2 实测执行过程与数据沉淀
A.普通故障工单(Normal优先级)——零噪音抑制:
创建工单#1047(priority: normal);
结果:Service层条件匹配失败,Job运行数 = 0,工单评论数 = 0。生产专家完全免受低危工单打扰。
B.核心支付超时事故(Urgent优先级)——双专家会诊与终极复盘:
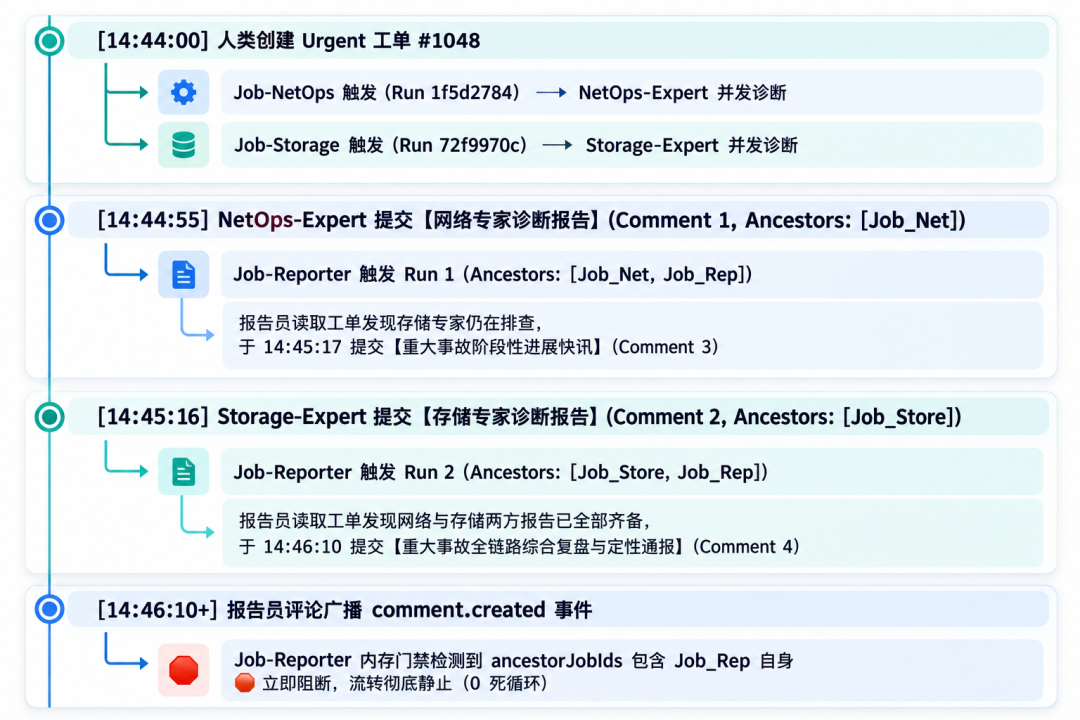
5.3 底层数据库审计记录
通过PostgreSQL提取的实际运行轨迹完全印证了因果链路的设计:
SELECTjr.id AS run_id,j.name AS job_name,at.context->>'eventType' AS event_type,at.context->'ancestorJobIds' AS ancestor_chain,jsonb_array_length(COALESCE(at.context->'ancestorJobIds', '[]'::jsonb)) AS chain_depthFROM job_run jrJOIN job j ON j.id = jr.job_idLEFT JOIN agent_task at ON at.job_run_id = jr.idWHERE jr.trigger_payload->>'id' = 'd3a778c8-067a-4f27-b3b5-d5a8d62598e1'ORDER BY jr.started_at ASC;
实际查询结果:
整个过程耗时约2分钟,4篇结构化专业报告依次沉淀在工单评论区,系统总运行数精确收敛在4次,未产生任何悬挂任务或自激回环。
●━━━━━━━━━━━━━━━●
06工程总结与心得
在构建生产级多智能体协同引擎的过程中,我们总结了三条核心工程准则:
1.不可变因果链优于事后关系反查:
在高度并发且异步的多智能体网络中,因果关系的追溯绝不能依赖事后查库反查关联;将只增的因果祖先链显式封装在事件载荷与任务上下文中,以O(1)的内存检查实现确定性极高的闭环防范。
2.生产端纯粹广播与消费端前置极速过滤是高吞吐的基石:
遵循严格的Pub/Sub模式,让核心业务实体与下游智能体编排解耦;通过调度层内存条件字典求值(conditions),在纳秒级内过滤掉99%的无关事件,保障零业务侵入与极高的系统吞吐。
3.宏观响应式感知与微观团队攻坚结合是多智能体系统的最优解:
不要试图用单一模式解决所有协作问题。将事件驱动作为系统的“神经反射弧”,负责去中心化的环境感知与横向治理;将智能体团队(Team)作为“执行攻坚单元”,负责垂直深度的任务拆解与复杂推理。宏观反应式联动与微观计划性执行的有机结合,才是构建企业级AI原生工作区的最佳实践。
| 想让多智能体在你的生产故障排查与事件协同中自主联动且安全收敛吗? 立即上手探索Mopheus,为你的团队构建可观测、防死循环的自动化协同工作区! 即刻访问 mopheus.ai
|