性能问题最终都要结算成时间。监控的价值,是把这笔账算到用户真正关心的地方,让每一次优化都能回答:究竟为谁,省下了多少时间。
在上一篇「让性能调优像电子游戏——图形界面的第一次革命」文章中,我们看到,实时曲线把性能调优从批阅报告变成了与系统连续交手。但仪表盘点亮以后,一个更难的问题浮现出来:曲线那么多,究竟该先追哪一条?缓存命中率明明很漂亮,CPU也可能并不繁忙,用户却仍在等,为什么?等待事件带来的变化,是让数据库用自己的语言交代:我刚才为什么没有继续工作,这次停顿持续了多久。性能诊断开始从资源猜谜,转向时间核算。
上一代图形工具解决了“看不见”,代价是屏幕上挤满曲线,形成“图表墙”。若仍按计数器大小和波动幅度挑问题,DBA只是把文本时代的误区搬进了窗口。早期监控界面的一次改进很有代表性:统一图表尺度,然后移除后台等待、空闲等待和无关等待,连等待次数也不再放在显眼位置。等待次数当然不是没有用,真正移除的是它在监控界面上的优先权。
这次改进的关键是换了排序标准:先问时间消耗在哪里,再决定哪项值得深究。红线最高、出现最频繁,都不自动等于业务代价最大。
这一转向改变了监控与人的分工。过去,工具负责堆数据,专家靠经验从中挑线索;现在,工具开始把“哪些停顿与当前问题有关、哪些消耗值得先查”组织出来。界面上的删减,背后其实是诊断方法的进步:注意力有限,必须按代价分配。
在Oracle 8i的性能指南中,V$SYSTEM_EVENT、V$SESSION_EVENT和V$SESSION_WAIT已经分别提供实例累计、会话累计与当前等待信息;文档还给出查询当前会话等待的示例。数据库内部的停顿,开始成为可以直接询问的状态。
Oracle会在会话无法继续处理时记录等待事件。它可能在等一次单块读完成,等日志写入进程确认提交,等另一会话释放行锁,也可能只是等客户端发来下一条SQL。事件名描述的是当时的处境,往往是症状,不是根因,更不是严重性判断。
因此,第一轮过滤十分重要。SQL*Net message from client通常表示数据库在等应用发来工作,属于空闲等待;Oracle 10g文档已将等待归入Application、Commit、User I/O、Idle等类别,方便先看问题方向。后台等待也不该直接混入前台时间排名,但排查提交变慢时,仍要回头检查日志写入等后台活动。筛选是安排阅读顺序,不是丢掉证据。
假设事件A发生100万次,每次平均0.05毫秒,总共50秒;事件B只发生20次,每次5秒,总共100秒。按次数排序,A遥遥领先;按总时间排序,B的代价是A的两倍。Oracle官方文档已明确提醒:发生次数最多的等待,未必是主要瓶颈;只有启用TIMED_STATISTICS,拿到等待时间,才能判断它是否值得调查。计数让人看到“停了多少回”,计时才让人接近“损失了多少”。
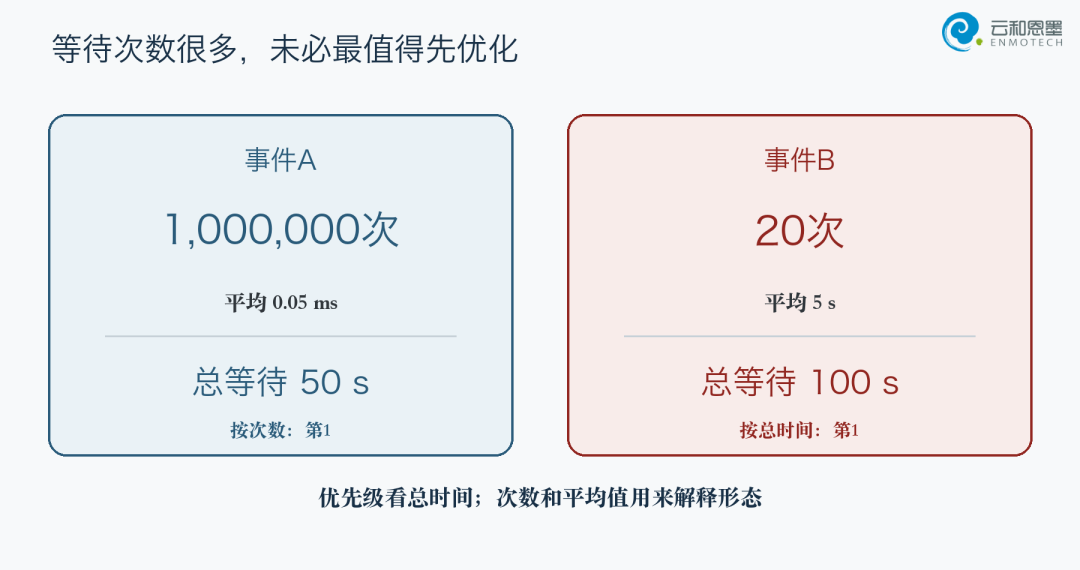
图1:同一批等待数据,按次数与按总时间会得到相反的调优顺序。
平均等待同样不能单独定案。它会把尖峰摊平,也无法告诉你这些等待是否集中在关键交易时段。比较性能必须限定时间窗,用窗口前后的累计增量,不能拿实例启动以来的总数直接下结论。次数适合解释频率,总时间负责决定排查顺序,长尾还需要更细的明细数据。
总时间也不是脱离上下文的裁决。100秒等待若由100个会话同时承担,可能发生在很短的墙钟窗口里;若由一个会话连续承担,那个用户就实实在在等了100秒。计时解决了单位问题,尚未解决受影响对象的问题。排查必须把时间和参与者重新连起来。
早期工具曾把log_file_switch_completion直接连到“增大日志文件”这一动作,把free_buffer_waits连到“增加缓冲区”。这是巨大进步——图不再只说“这里高了”,而是尝试把专家经验放进界面。但站在今天回头看这些建议,DBA更应该把它们当作诊断假设,而不是按钮说明书。
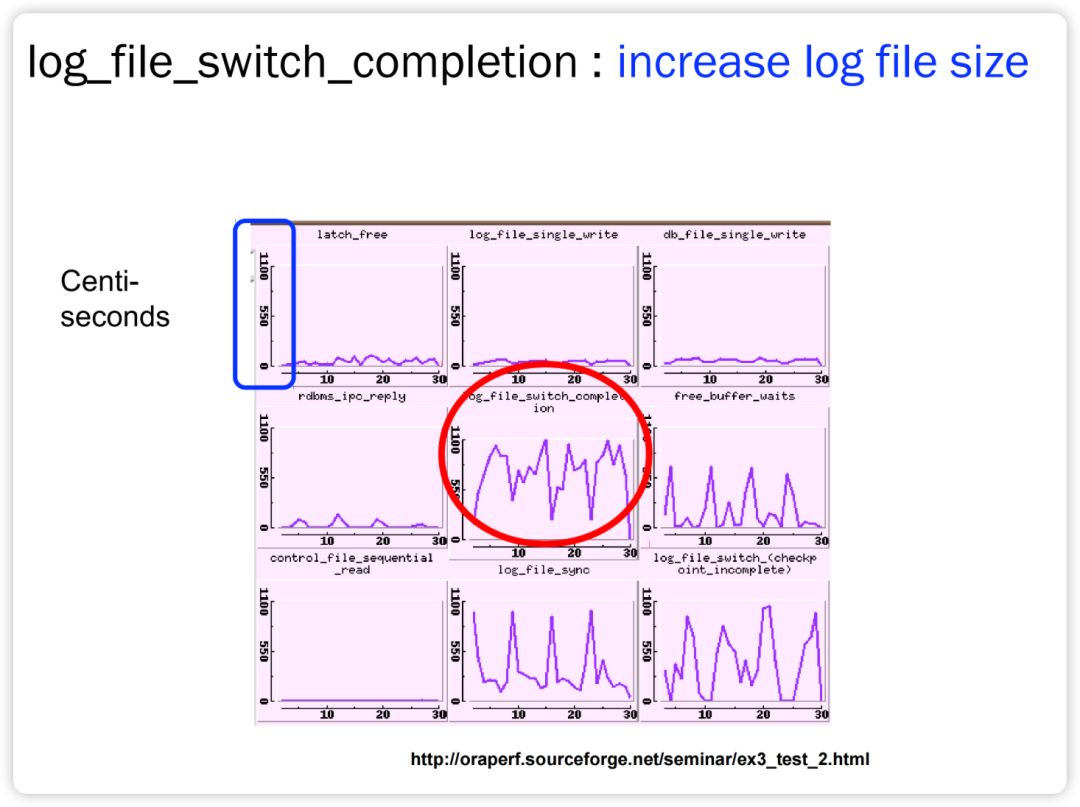
图2:早期界面已经尝试从等待事件给出调优动作。
以log file sync为例,表面上都是提交等待,背后可能是应用提交过于频繁、redo写入延迟、LGWR调度受阻,或同步保护链路变慢。db file sequential read常见于单块读,既可能来自高效索引访问,也可能是某条SQL执行计划失控后反复随机读。先看事件,再找产生它的会话、SQL和对象;没走完这一步,改参数只是碰运气。
今天,zCloud在锁分析中承接的,正是这条“从事件走向证据”的路径。当行锁等待排到前面时,界面不只是告诉DBA某个等待事件变高了,而是继续把它关联到实时或历史阻塞链,进一步追到持锁会话、相关SQL、事务与锁状态。这样,等待事件先指出“时间可能花在这里”,阻塞关系和会话上下文再帮助判断“是谁造成了等待、该先处理哪一端”。它延续了早期工具“把专家经验放进界面”的方向,但不再把事件名直接翻译成操作按钮,而是把诊断所需的证据链补齐。
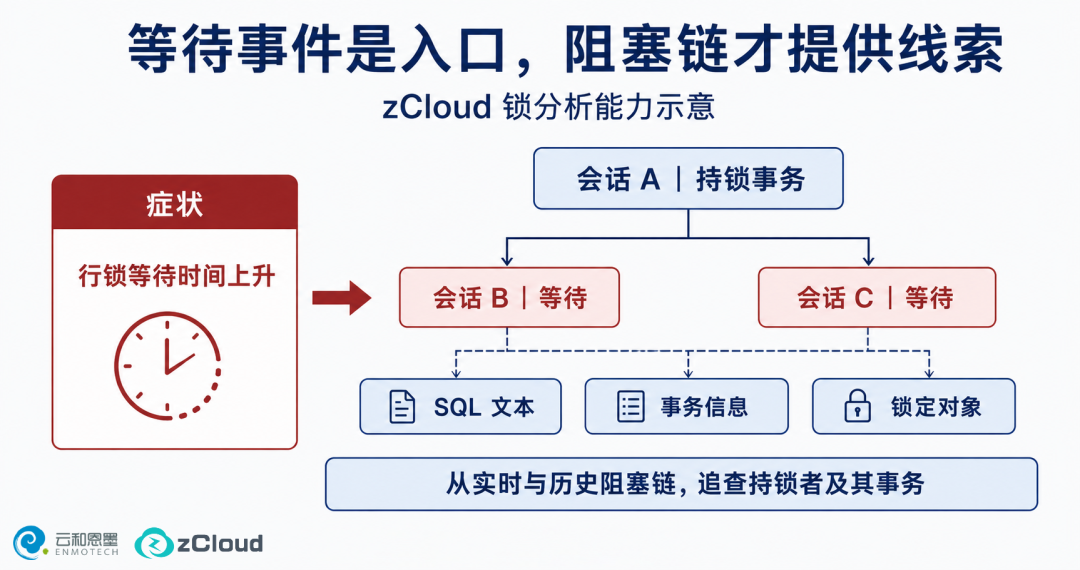
图3:zCloud锁分析能力示意。
只画等待仍然少了一块重要的拼图:会话正在CPU上执行时并没有等待事件。若把所有非空闲等待降低一半,但SQL多消耗了两倍CPU,用户不会因此更快。数据库性能监控与可视化专家凯尔·海利(Kyle Hailey)曾复盘自己调优Oracle 7的catproc.sql,给这类行为起了一个很传神的名字:Compulsive Tuning Disorder(强迫性调优紊乱)。其病因就是缺少CPU作参照。
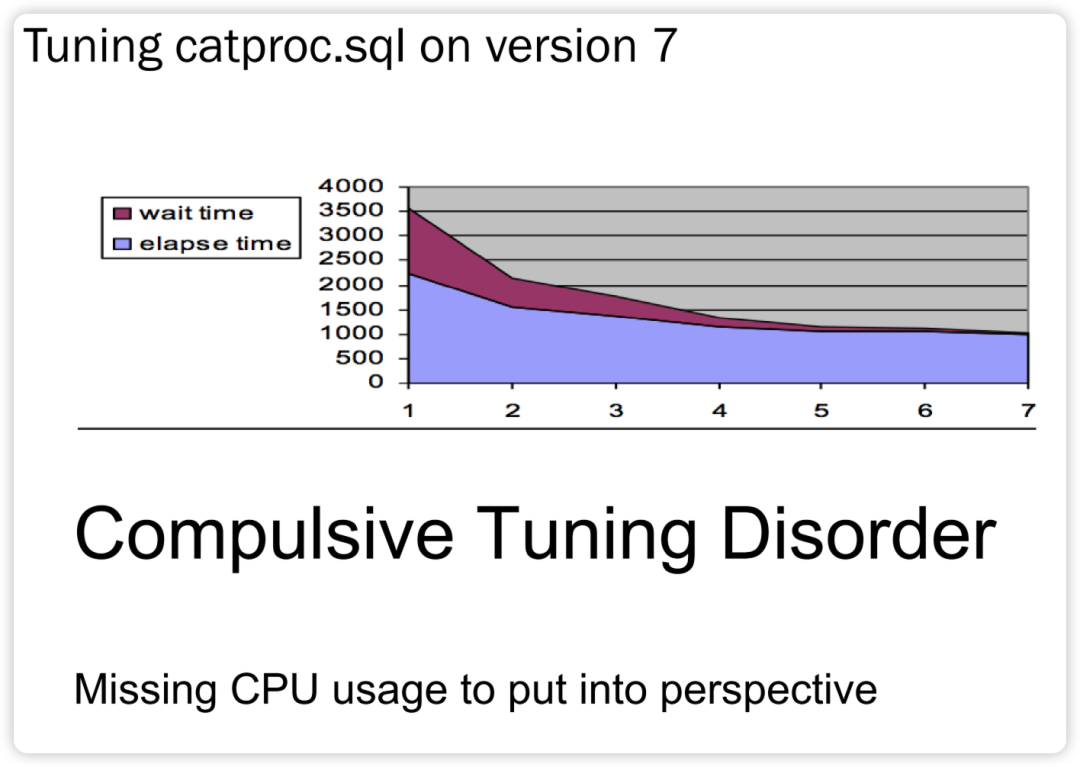
图4:只看等待下降、不把CPU放进上下文,容易患上“强迫性调优紊乱”。
到了Oracle 10g,新特性指南把“增强的数据库时间模型”列为管理基础设施,记录解析、执行、I/O等内部操作的时间。时间不再只是等待事件统计表中的一个字段,而开始成为衡量不同调优方向的共同尺度。
Oracle把前台非空闲会话处理数据库调用的累计时间称为DB Time,实践中可以理解为DB CPU加上非空闲等待时间。CPU、I/O、锁、提交不再各说各的单位,都换算成用户在数据库上消耗的时间。排序也就有了共同分母:某项消耗占DB Time多少,减少它最多能换回多少时间。
例如,同一批请求原先花60秒CPU、40秒等待;优化后等待降到10秒,CPU却升到100秒。等待曲线好看了,累计代价反而从100秒变成110秒。这个假设例子说明,只看被调整的那一项,容易把成本转移当成优化成果;验收必须回到完整账本。
DB Time按活动会话累加,因此可以大于自然流逝时间。四个会话同时忙5分钟,数据库可能记下约20分钟DB Time。这是并发工作量,并非统计错误。将区间DB Time除以区间秒数,得到平均活动会话数;不过,其中包含等待中的会话,不能把它直接当成CPU使用率。要判断系统是否接近CPU容量,还要把活动会话、CPU核数和墙钟时间放在一起看。
DB Time也不等于完整的用户响应时间。应用服务器计算、网络往返、连接池排队和客户端渲染都可能发生在数据库之外。DB Time很适合回答“数据库这一段时间花在哪”,却不能替应用全链路作结论。先界定边界,再看账本,这是使用时间模型的基本纪律。
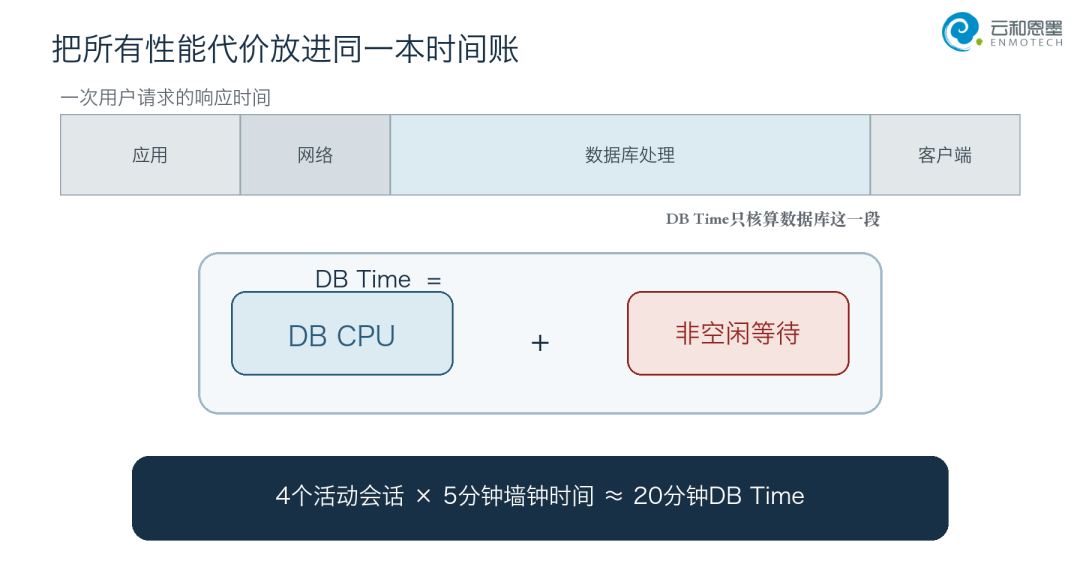
图5:时间账既要包含CPU,也要划清数据库与端到端响应的边界。
到了Spotlight及后来的Enterprise Manager,CPU与等待开始出现在同一活动尺度上。图形终于能回答一个朴素问题:当前负载主要是在做计算,还是被I/O、锁、提交或并发控制拖住?CPU容量线可以辅助判断活动量是否逼近机器能力,但总活动量越过这条线,并不能单独证明CPU已经耗尽。
Oracle 10g时代的ADDM(Automatic Database Diagnostic Monitor,自动数据库诊断监视器)又把这条原则推进一步:按问题消耗的DB Time排序,估算建议能节省的时间,也指出哪些区域并非主要问题。好的诊断不仅告诉DBA该查什么,也帮助他停止在小问题上反复打转。
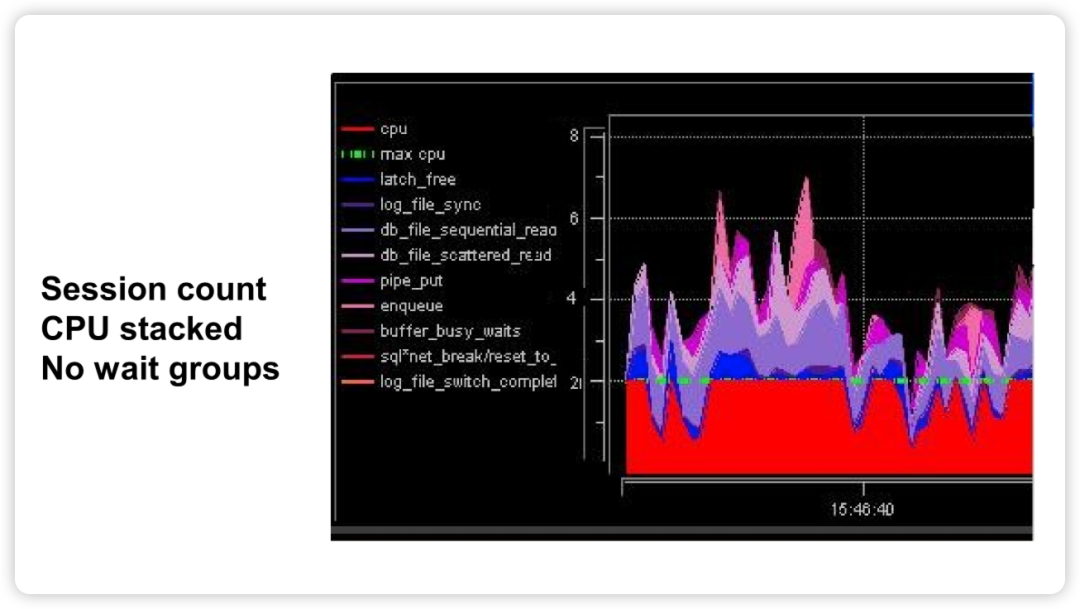
图6:CPU与等待在同一活动尺度上堆叠显示。
2003年,凯瑞·米尔萨普¹(Cary Millsap)等人在《Optimizing Oracle Performance》一书中系统阐述了Method R,将用户操作和响应时间置于性能优化的核心。
这里还需要进一步追问:耗时最多的问题,就一定是当前最需要解决的问题吗?未必。夜间批处理可能占据了数据库大部分DB Time,但如果它运行正常、并不影响业务,那么优先级未必最高;反而是一笔只占很少DB Time、却正在超时的支付交易,更值得立即处理。时间告诉我们哪里花费最多,而业务目标决定我们应该先优化哪里。
假设一次交易耗时10秒,如果某项等待只占0.2秒,那么即使把它完全消除,对整体耗时的改善也十分有限。反过来,一个占用8秒的环节,即便只优化一部分,也可能带来明显的性能提升。时间模型的价值,就在于让我们能够在动手之前先算清楚优化的潜在收益,把精力放在真正影响体验的环节上,避免“折腾了半天,用户却毫无感觉”。
¹ 凯瑞·米尔萨普(Cary Millsap),著名Oracle性能专家,曾长期负责Oracle系统性能团队。1999年离开Oracle后,他与Gary Goodman创立Hotsos,后来进一步创立Method R,并与Jeff Holt合著《Optimizing Oracle Performance》,将以响应时间为核心的Method R性能优化方法系统化。

在zCloud的性能分析图表中,可以查看时间消耗异常时段内的TOP SQL、TOP Event、TOP Session,并与历史时段对比;SQL分析还可以进一步查看执行计划和性能基线。这些能力的意义,正在于把“总时间优先”推进到具体对象:先圈定变慢的那段业务,再查是谁增加了时间开销,而不是把全库榜首当成每次故障的答案。
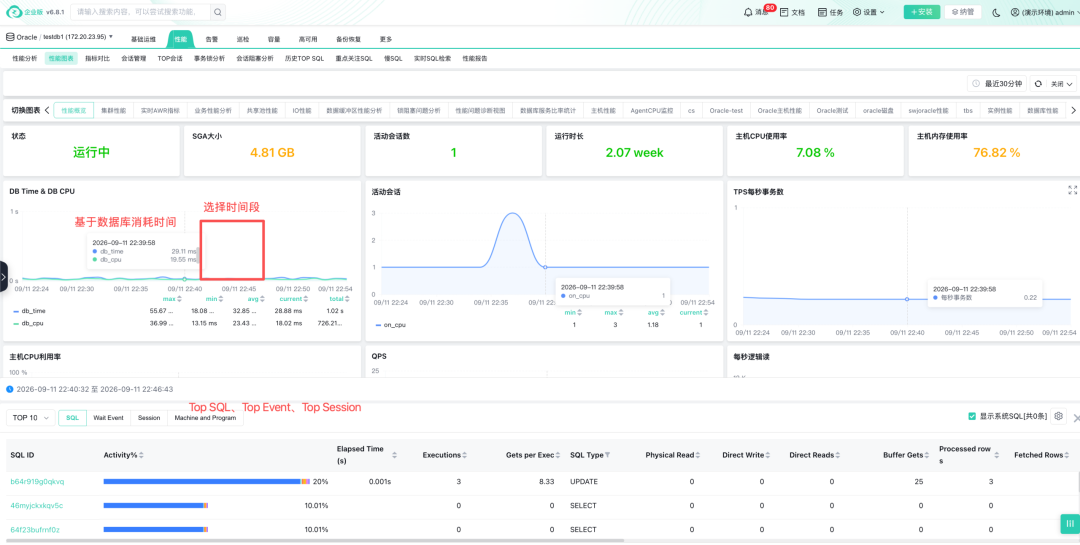
图7:在zCloud的性能图表中,可以查看时间消耗异常时段内的TOP SQL、TOP Event、TOP Session等。
-
先确定业务窗口。确认哪项交易慢、从几点到几点、正常基线是多少。没有边界,所有累加统计都会撒谎。
-
再看DB Time增量。把故障窗口与正常窗口比较,判断数据库工作量是否增加,以及增长是否足以解释响应时间变化。
-
把CPU和等待拆开。CPU占主导就查高CPU SQL与执行计划;等待占主导则按总等待时间和占DB Time比例排序。
-
次数只作辅助。总时间决定先后,次数与平均等待帮助区分“高频短停顿”还是“低频长阻塞”,必要时再看长尾。
-
沿证据链下钻。从等待类别走向事件,再到会话、SQL、执行计划、对象、文件或阻塞者;提出假设,只改一个变量,然后复测。
等待事件是一张按时间排列的“症状清单”。它最重要的贡献,是让DBA先处理代价最大的方向,再用SQL和会话证据决定具体动作。
等待事件和DB Time完成的跨越,是让性能诊断有了可比较的代价。但时间账不是根因目录:同样100秒等待,可能来自一条SQL,也可能由许多会话共同承担。总账负责指方向,明细负责找原因,业务结果负责验收。
这也给自动化诊断划定了目标:不是把所有等待都清零,而是把有限的排查与变更成本,用在能改善服务的地方。数据库正常工作就会发生等待;真正需要解释的,是哪些等待偏离了业务需要,以及采取行动能换回什么。
从计数器到等待时间,从局部等待到CPU与等待的统一核算,监控逐渐学会了尊重用户付出的时间。它的成熟,不在于能列出多少种等待,而在于能否解释哪一段时间值得缩短、为什么可以缩短,并在改变之后证明:同样的工作,确实让用户少等了。
-
Kyle Hailey, History of Database Monitoring, 2016. https://www.slideshare.net/khailey/history-of-database-monitoring
-
Oracle8i Designing and Tuning for Performance, Release 2, §15 Dynamic Performance Views
-
Oracle Database 10g Release 2 Performance Tuning Guide, §5.1.1.1—5.1.1.2 Waiting Categories and Time Models
-
Oracle9i Database Performance Guide and Reference, §20 Oracle Tools to Gather Database Statistics
-
Oracle Database 10g Release 2 Performance Tuning Guide, §10 Instance Tuning Using Performance Views, log file sync、db file sequential read
-
云和恩墨:《zCloud技术白皮书》
-
Oracle Database 10g Release 1 New Features Guide, Manageability Infrastructure, Enhanced Database Time Model
-
Oracle Database 2 Day + Performance Tuning Guide, Time Model Statistics, DB Time and User Response Time
-
Oracle Database 10g Release 2 Performance Tuning Guide, §6.2—6.2.1 Automatic Performance Diagnostics
-
Cary Millsap, Jeff Holt, Optimizing Oracle Performance, O'Reilly,2003年9月,第1—2章
扫码添加云和恩墨小助手
备注“监控咨询”