我是如何每天与AI Agent协作的——基于单设备10个月日志、11.5万步轨迹与4.9万次工具调用的实证复盘
当大型语言模型(LLM)被赋予上下文检索、文件操作、进程守护与终端调度能力时,它在工程中的定位便发生了本质变化:从一个“提供代码片段的对话助手”,演进为一个常驻于操作系统与研发流水线中的“系统级协同者”。
在过去的10个月中(2025年11月21日至2026年9月30日),我在混合Windows宿主机、WSL Linux容器与远程云端环境的复杂研发场景中,持续推进核心系统的演进与重构。所有交互细节、状态流转与工具调用均由底层的元数据库与运行日志完整留痕。
前置说明(关于统计口径与真实工作量):必须强调的是,这组数据绝非我日常研发工作的全貌。它仅仅是我个人单台Windows桌面工作站上、仅针对antigravity这一款本地Agent CLI工具的日志统计。在我的日常实际工程体系中,我还高频使用Codex以及其他主力macOS开发机;那些终端与工具产生的海量会话、代码变更与自动化任务均未纳入本次统计。如果将所有设备与工具链的工作量全部汇总,真实的工程调度规模远比本文记录的还要庞大得多。但正因如此,即使仅仅剖析这“冰山一角”的单机单客户端局部切片,其沉淀出的10个月、113个会话、11.5万步执行轨迹与近5万次实体工具调用,也足以呈现高强度人机协同中最真实的工程规律与架构启示。
01真实工程环境下的基线数据
以下数据提取自该期间我本地Windows工作站上持久化存储的系统日志与执行元数据:
这些数字背后,反映出真实生产工程场景中智能体协作的实际运行特征。
●━━━━━━━━━━━━━━━●
02工具调用分布与「90/10倒冰山法则」
对49,659次原生工具调用的调用频次进行聚合统计,分布如下:
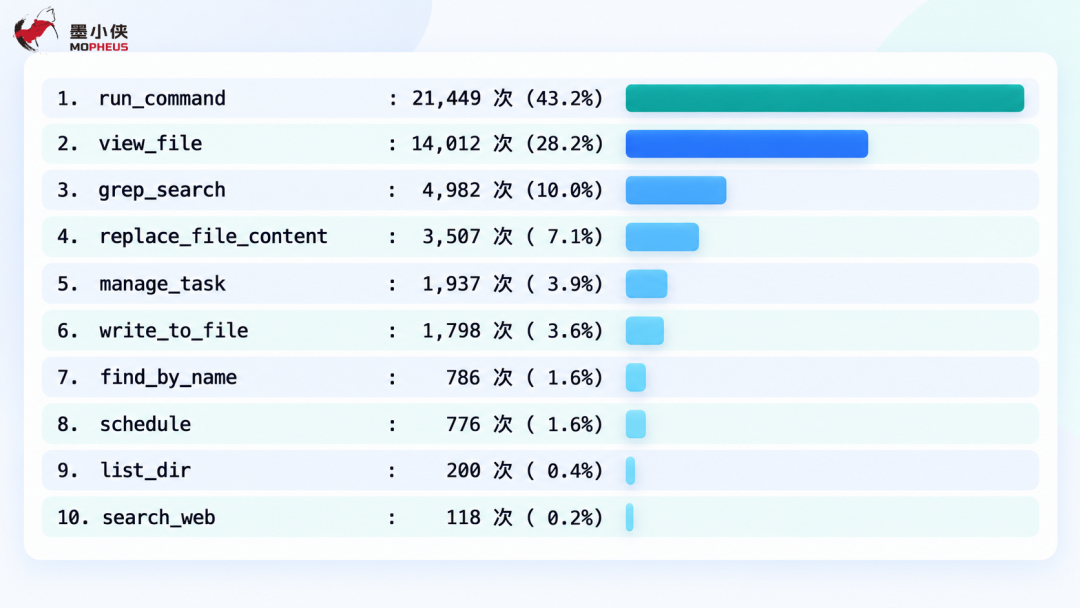
从该分布中可以提炼出三个关键工程规律:
1. 软件工程的「90/10倒冰山法则」
在普遍直觉中,智能体编程常被误解为“主要在写代码”。但统计分类揭示了一个极为客观的工程事实:
-
环境感知与代码走查(Read & Trace):
view_file(14,012)+grep_search(4,982)+find_by_name(786)+list_dir(200)= 19,980次(40.2%)
-
运行验证与流程调度(Execute & Monitor):
run_command(21,449)+manage_task(1,937)+schedule(776)= 24,162次(48.7%)
-
代码修改与生成(Mutate & Write):
replace_file_content(3,507)+write_to_file(1,798)= 5,305次(仅占10.7%)
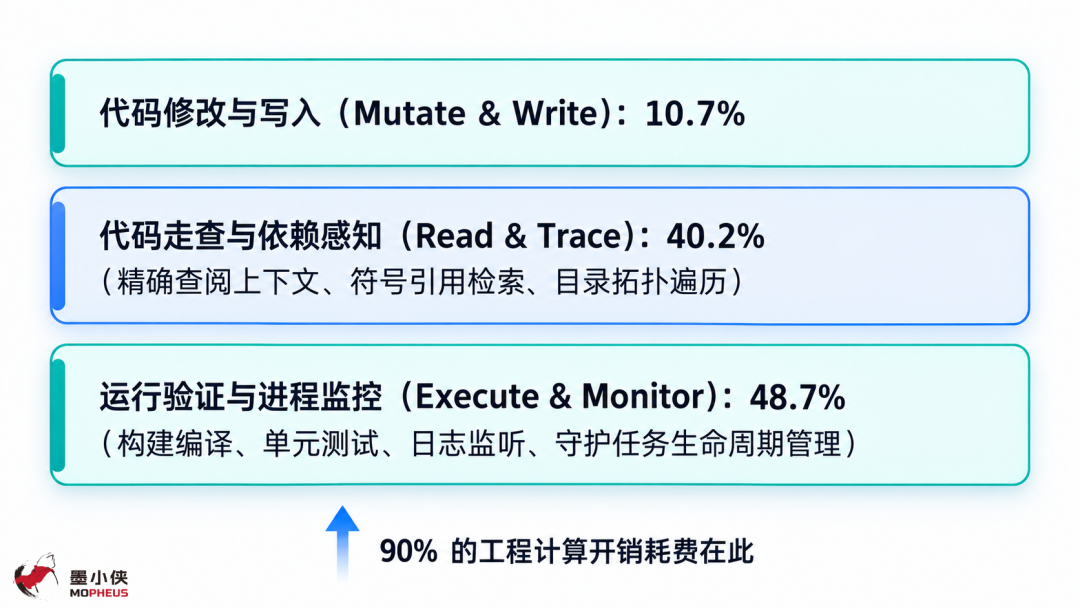
在具有复杂业务约束的中大型仓库中,代码修改本身仅占Agent行动总量的10%左右。另外90%的调用开销均集中在“厘清原有依赖、定位符号定义、运行测试套件、监听守护日志与捕获运行时异常”。
脱离上下文走查与运行闭环的代码生成,在复杂系统中往往面临高昂的排错成本。
2. 代码修改形态:以块替换为主的底层通用机制
在代码修改与写入的5,305次操作中,局部块替换(replace_file_content,3,507次)与新建或全文件覆写(write_to_file,1,798次)的比例约为2:1。
这是目前主流Coding Agent(如Claude Code、Cursor、Antigravity等)通用的底层工具机制——通过定向替换局部代码块,尽量降低对未涉及代码的扰动与性能损耗。这组数据客观印证了:在当前的智能体工程实践中,以块替换为主已成为行业标准的默认行为惯性。
3. 命令执行与代码事实优先
排在首位的run_command达到了21,449次。在其调用的二进制前置分布中,涵盖了我日常开发的完整链路:
· git(4,072次):Worktree创建、分支切换、Commit提炼与合并;
· mopheus / mop(3,587次):工作区管理、工单流转与任务状态同步;
· python(1,388次)/ go(942次)/ pnpm(813次):多语言编译构建与测试套件校验;
· gh(1,325次):代码评审与交付生命周期管理。
值得注意的是,通用网络搜索search_web仅占0.2%(118次)。面对高并发状态机、内存竞争和多端水合等深层工程问题,通用网络检索往往缺乏项目特定上下文,高密度的准确事实始终存在于当前仓库的代码实现、历史提交日志与运行时Trace中。
●━━━━━━━━━━━━━━━●
03协作演进的四个阶段
分析这113个会话在过去10个月中的时间跨度,我与智能体的协作模式经历了四个清晰的演进阶段:
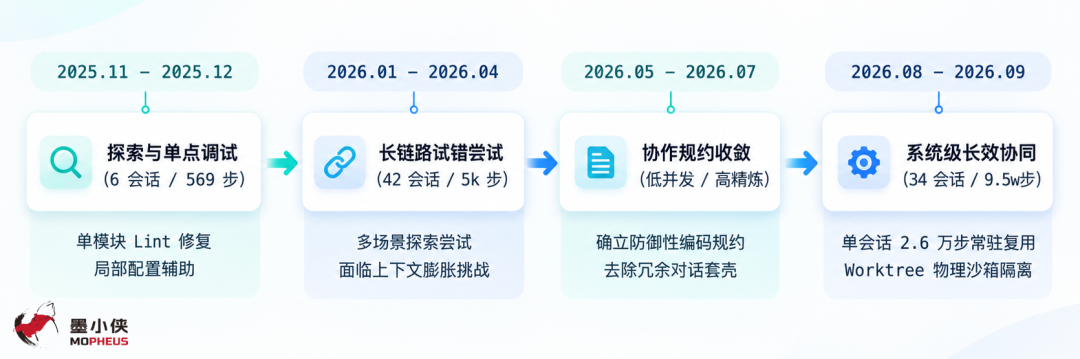
1.探索与单点调试(2025.11 - 2025.12):处理单模块Lint修复、配置排查等低深度任务,平均单会话步数在数十步以内。
2.长链路试错尝试(2026.01 - 2026.04):开始尝试让智能体处理较长的执行链条,探索MCP等扩展协议,但面临长路径下的上下文膨胀与关注点漂移。
3.协作规约收敛(2026.05 - 2026.07):明确工程防御规范:
· 确立精炼沟通模式:精简客套和冗长过渡,专注技术事实与状态反馈;
· 确立最小改动原则(Simplicity First):不引入非必要抽象,不修改无关文件;
· 确立编码前推演(Think Before Coding):先理清前置假设与影响面,再落盘代码。
4.多任务常驻复用与会话超载挑战(2026.08 - 2026.09):在此阶段,我开始将智能体会话作为常驻工作台(Resident Session)使用,甚至出现了单个Session跨越半个月、连续复用处理数十项互不相同的研发任务、累计执行达26,138步的记录。
开发者之所以倾向于复用会话,是因为极度渴望保持“热态上下文”——不愿在每一次切任务时打断心流、频繁经历“冷启动”向Agent重新交代分支与环境。但这种常驻复用模式也直接撞上了原生CLI工具的结构性墙壁:历史上下文过度膨胀、不同任务的碎片化信息互相污染、以及跨任务Git分支状态交织难以原子化回滚。这直接促使我将后续的协作防线全面转向“Git Worktree物理沙箱隔离”与“独立任务生命周期”。
●━━━━━━━━━━━━━━━●
04日常工程中的五项实操规约
通过对我2,869条有效用户指令的模式分析,高频协作中沉淀出了五项行之有效的实操规约:
1. 实体与指针锚定(Anchor-Driven Direction)
· 现象:10.4%的输入直接携带需求编号或工单UUID,大量指令精确包含文件路径与具体行号(如manager.go:54)。
· 实践:避免“帮我排查这个模块报错”等模糊提问,提供明确的工单ID、Commit SHA或文件行号定位,智能体第一步即可准确挂载上下文切片,避免盲目搜索带来的噪音。
2. 对抗性推演与边界审问(Grill Stress-Testing)
· 现象:在我的全部输入中,探究式与反诘式指令(包含“为什么”“是否会导致”“如何实现”“怎么证明”)占比达27.7%。
· 实践:在复杂架构设计中,不要急于要求输出代码,而是就状态流转边界、并发死锁风险、降级容灾机制与智能体展开推演对齐。只有在设计闭环后,才执行代码变更。
3. Git Worktree物理隔离(Zero-Dirty-Workspace)
· 现象:执行路径统计中,在独立Worktree目录下执行的命令占比超过30%。
· 实践:每一次特性改造或缺陷排查,均在物理独立的Git Worktree中进行。主分支工作区始终保持洁净,智能体在独立沙箱中自由构建与回归,验证完毕通过干净分支合入,失败则可快速整洁销毁。
4. 流程资产化为可复用技能(Codifying SOP as Skills)
· 现象:当某种多步骤流程重复出现时,将其固化为标准化的Agent Skill:
· 集成预览同步技能:完成迁移执行、服务拉起与凭据输出;
· 工单规格化技能:将讨论共识沉淀为零歧义的执行工单;
· 交付自动化技能:一键驱动代码验证、语义化提交生成与评审流转。
在后期会话中,约7.0%的高层指令直接通过技能命令调用,驱动跨环节的标准化交付。
5. 状态驱动与可验证闭环
· 现象:15.6%的用户输入长度在20字符以内(如“跑一下测试”“检查后台日志”“直接改”)。
· 实践:在顶层设计对齐后,人类输入迅速转变为高信噪比的状态驱动信号。交付以“全链路验证闭环”为准则:编译通过、测试通过、后台守护日志无异常方可认定任务完成。
●━━━━━━━━━━━━━━━●
05双机流转实践:Windows大屏构思 ➔ 工单沉淀 ➔ macOS编码落地
理解这组统计数据,还需要放到一个更真实的跨设备工程流水线中去审视。
很多时候,我的日常工作并不是在单台机器上一气呵成,而是在Windows桌面工作站与独立的MacBook Pro之间进行明确分工与异步流转:
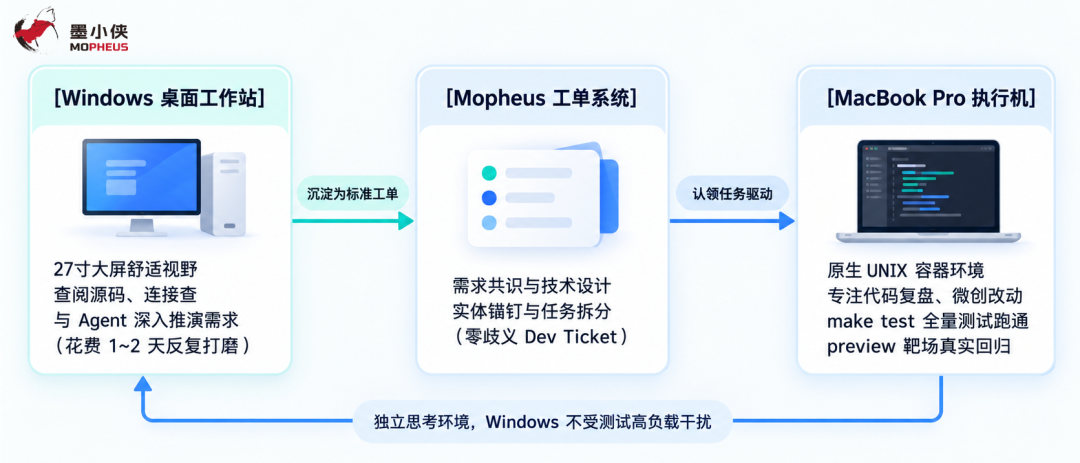
这种双机协同的分工逻辑建立在四个极其务实的工程考量之上:
1.大屏视野与人机推演舒适度(Windows桌面):
在面对复杂业务和底层重构时,我通常会在Windows台式机的大外接屏幕上,与智能体花费1到2天的时间反复推演边界、质疑假设、审查技术规范并打磨设计文档。大屏幕为高密度的多窗口走查、架构拓扑阅读与深度文字推演提供了最舒适的沉浸视野。
2.跨系统环境顺畅度(macOS编码落地):
当设计方案打磨完毕、形成明确结论后,实际的代码编写、单元测试以及集成preview靶场测试,我会切换到独立的MacBook Pro上进行。macOS原生POSIX/UNIX环境在跑容器化中间件、自动化测试与前端构建时更为顺畅自然,完全免去了Windows与WSL之间的跨文件系统I/O损耗与端口映射配置。
3.重型计算资源隔离(避免主工作机卡顿):
在工业级仓库中,执行make test、全量集成回归测试以及拉起preview靶场是高度消耗CPU与内存的重负载任务。将其完全转移到独立的MacBook Pro机器上跑,无论测试如何高负载运转、风扇如何轰鸣,都丝毫不会挤占Windows主工作站的CPU和图形资源。在测试运行期间,我可以继续在Windows大屏上保持丝滑流畅地沟通讨论其他需求、推演下一批设计方案。
4.以工单作为跨机协作与上下文载体:
让“Windows上做设计”与“MacBook Pro上做实现”得以无缝衔接的核心,正是Mopheus工单机制。
在Windows上耗费一两天推演出的成果,绝不会散落在临时的聊天窗口里,而是直接结构化沉淀为一张目标明确、边界清晰的Mopheus Dev Ticket(包含关联Issue、架构设计、技术约束与验证要求)。到了MacBook Pro上,我(或智能体)直接拉取工单上下文,启动独立的沙箱与Worktree开始实现。工单在此处不是繁琐的流程负担,而是极其实用的跨设备上下文胶囊与协作中枢。
●━━━━━━━━━━━━━━━●
06模式差异:对话式使用 vs 任务编排模式
将两者在关键工程维度进行结构化对比:
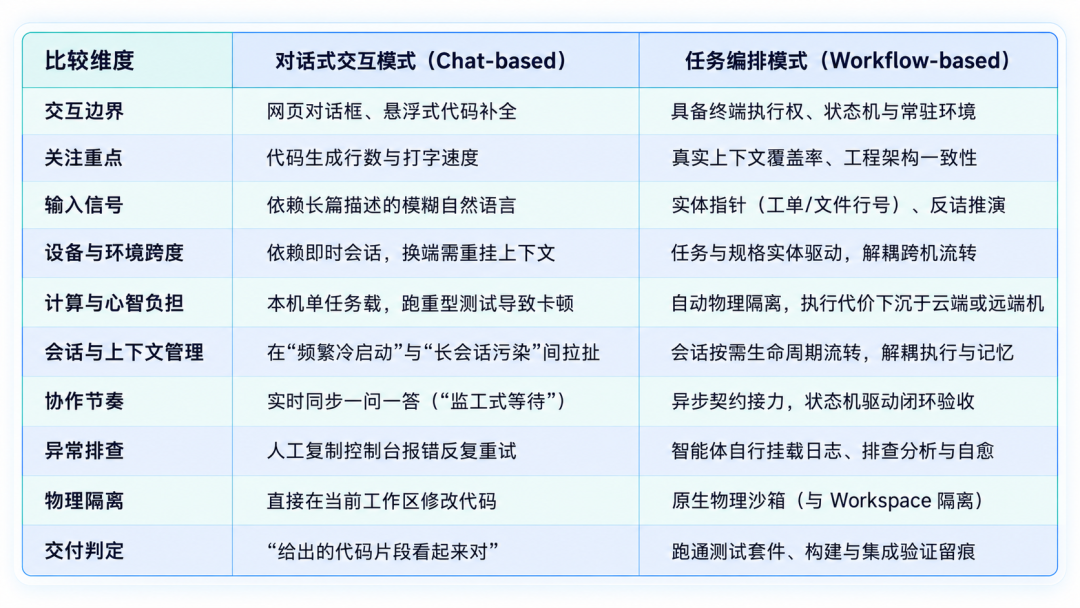
结合第五章的双机流转实践,这种模式差异其实并不是非此即彼的对立,更谈不上没有工单就“走投无路”。客观而言,很多团队早已习惯通过Git仓库提交Spec或设计Markdown跨机传递规格,这在今天本身就是非常成熟的工程实践。
对我个人而言,引入工单机制并采用双机流转,并不是为了追求什么宏大概念,而只是在真实日常中为了解决两个非常具象的操作舒适度问题:
-
上下文阶段性归拢,避免无限滚雪球:在单会话里连续做很多事情确实省心,但久而久之难免会有历史噪音累积与分支混乱。把1~2天推演的结论落成一个工单(或清晰的技术规格),相当于在发散探索与具体执行之间做了一次阶段性归档。MacBook上的执行端拿到工单直接开工,既不需要从零反复交代背景,也不必背负前期讨论时的冗长对话历史,做完一件交付一件,节奏更清爽。
-
把高负载执行交给独立机器,保护主工作站的思考心流:在工业级仓库中,
make test、容器构建和集成回归是典型的吃CPU、起风扇任务。把这些重活甩给独立的MacBook Pro去跑,Windows台式机上的大屏视野和系统资源就能完全释放出来。测试在后台跑它的,我可以在台式机上继续查阅文档、推演下一个设计,互不干扰。
在这里,Mopheus的工单更像是一个自然的工作交接卡片——它把前期的“方案讨论与推演”和后期的“代码落地与验证”划分出清晰阶段,让人脑专注于方案打磨,让机器独立承接重负载执行。
真正的智能体协同,不是简单替代人类的系统思考,而是借助智能体高效的信息检索、代码走查与命令执行能力,放大工程师在系统设计、边界防御与架构决策上的价值。
人类把控系统演进方向、审视临界条件并实施终审;智能体承接依赖定位、构建验证、代码变更与测试守护。当人机分工回归到这种清晰的协作阵位时,软件工程的日常研发形态,便悄然迈上了一个更为扎实、从容的新台阶。
| 想在真实工程中体验 具备终端执行、沙箱隔离与长效闭环能力的智能体协同吗?立即上手探索Mopheus,开启以工程质量与实证为核心的人机协同新实践!即刻访问 mopheus.ai
|