数据库监控应当坚守的,是让异常有迹可循、判断有据可依、处置有果可验,让每一次故障都成为下一次稳定运行的经验。
上一篇「ASH与AAS——用采样重建数据库活动现场」讲到,ASH把时间、会话、SQL与等待一并记录,AAS则把活动强度画在时间轴上。此后,数据库监控工具逐渐形成了相似的界面语言:堆叠活动、Top SQL、Top Sessions,再加上一层层下钻。图表和下钻能力越来越丰富,值班DBA却未必少接电话。本文继续追问:实时监控、周期巡检与故障诊断分别解决什么问题,它们又怎样连接成一条能够验证结果、沉淀经验的处置链?
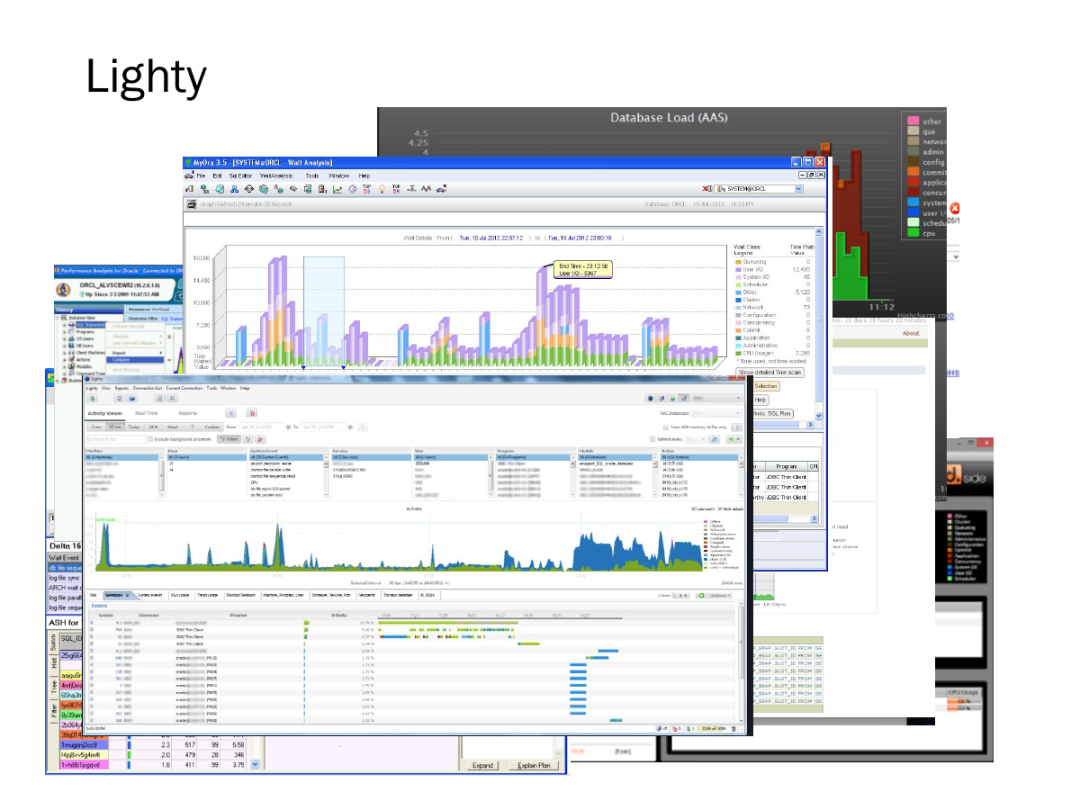
¹ “寒武纪大爆发”原指地质史上动物类群快速多样化的事件。凯尔·海利(Kyle Hailey)在2016年9月公开的153张幻灯片演讲《History of Database Monitoring》中,以个人经历回顾数据库性能工具的演进。他在第98张幻灯片写下“Cambrian Explosion: YaaMs”,并在随后数页连续列举多款工具,以此比喻围绕活动会话采样与AAS方法的监控产品集中涌现。YaaMs是一个带有戏谑意味的简称,可理解为一批“Yet Another Activity Monitor(又一款活动监控器)”。

窗口叠在一起,曲线、柱子、表格挤成一团,并不意味着判断能更清楚。《数据库监控简史》系列第一篇「13张图表为什么没能阻止一场灾难」曾借“挑战者号”案例说明:数据多,并不等于证据组织得好。
“图表墙”最容易制造一种错觉:只要把CPU、I/O、连接数、锁、日志、缓存、SQL和主机指标都画出来,答案就会自行浮现。可阈值告警通常只说明某个条件被触发了,并不自动知道那是批处理窗口、版本发布、备份任务,还是业务活动把访问量放大了百倍。症状有颜色,因果关系仍然缺席。
Google在2016年出版的《Site Reliability Engineering》中明确区分症状与原因,并提醒:频繁、低价值的告警会持续消耗人的注意力,甚至淹没真正的故障。因此,告警首先要解释为什么值得打断值班人员,诊断则要继续追问异常为什么发生。
那本书中还提出延迟、流量、错误和饱和度四类关键信号。放到数据库场景,CPU升高要结合交易量理解,连接堆积要结合请求延迟判断。业务增长带来的繁忙与处理能力下降时形成的堵塞,不能因为曲线同样变红就采用同一张处方。
要解释异常原因,还需要补上等待、查询和变更上下文。我曾在墨天轮发表《拒绝“裸奔”:资深DBA眼中最值得拥有的7款数据库监控工具》。文中介绍的亮点能力分散在不同产品上:SolarWinds DPA突出等待时间分析,PMM的QAN和SQL Sentry分别提供查询分析与执行计划分析,Redgate SQL Monitor则可以把部署时间标记在性能时间线上。把这些功能放回数据库监控的历史脉络,可以看到同一演进方向在当代产品上的不同落点:监控先确定“什么时候变慢”,继而追查“在等什么、哪条SQL制造了负载”,再补充“异常之前发生了什么变更”。
2024年6月,Redgate发布了一篇Monitor 14使用文章,演示了如何通过PowerShell API添加注释,将部署、权限或配置变更等事件标记在性能时间轴上。异常旁边有了上下文,DBA才更容易提出可验证的假设。不过,变更与异常在时间上相邻,只能说明二者可能相关,还不能单独证明因果。发现异常、提前识别风险、解释故障原因,是三种不同的任务。图表开始承载越来越多诊断线索之后,监控、巡检与诊断的边界也就需要重新分清。
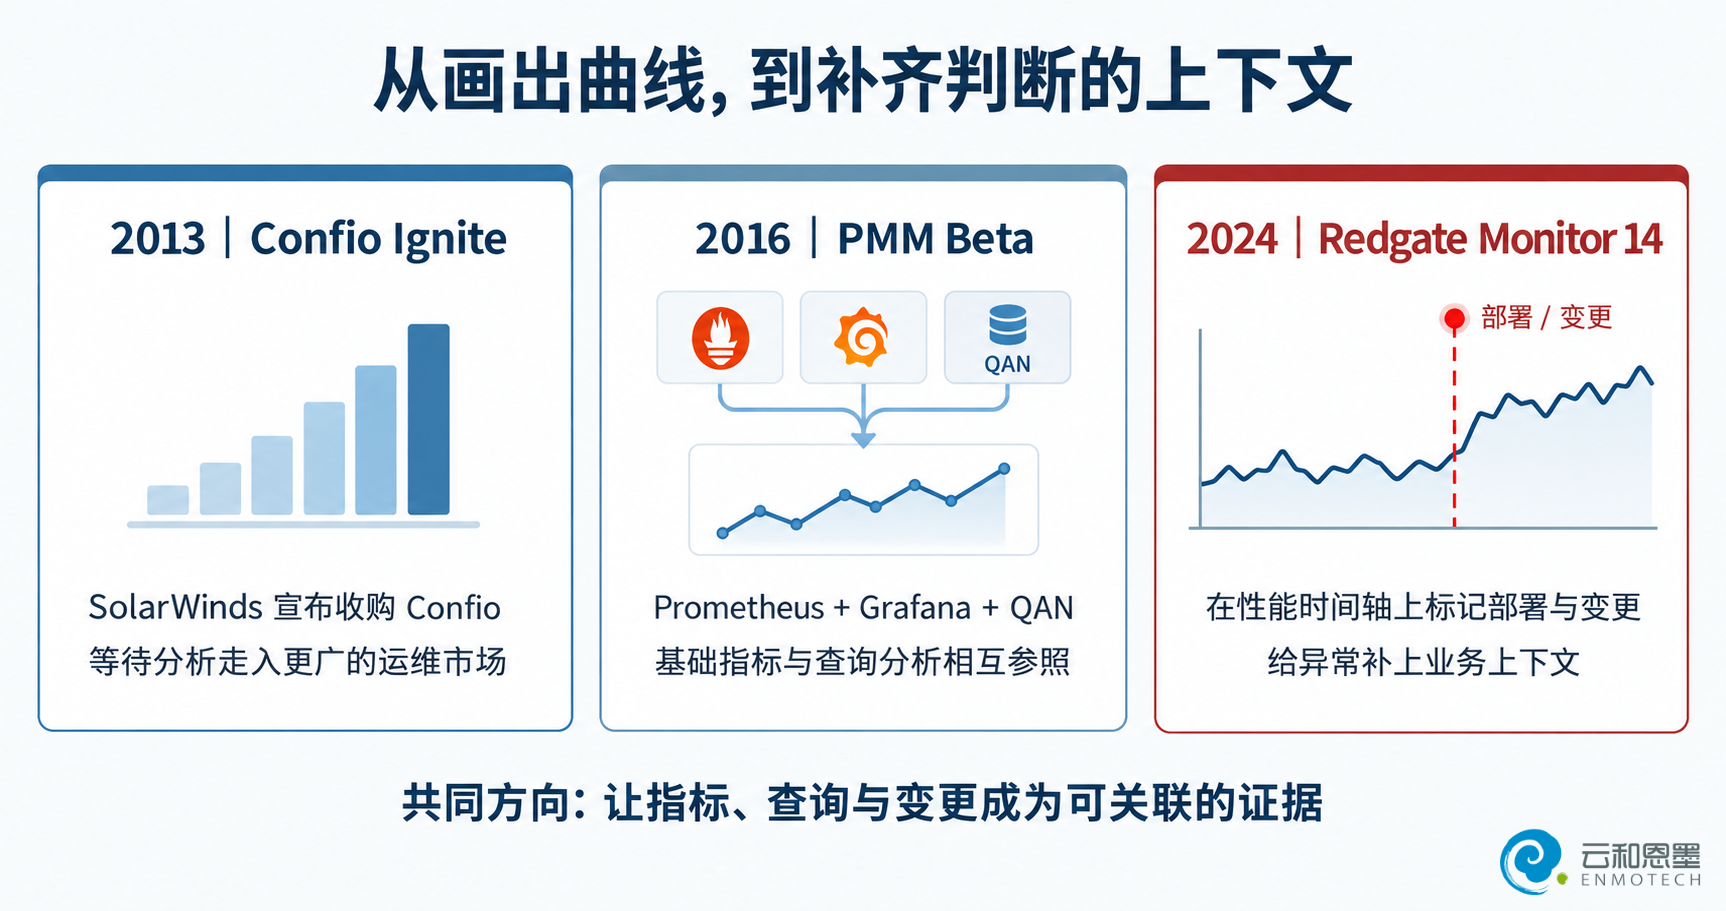
图2:等待分析、查询分析与变更标记,逐步补齐判断所需的上下文。
监控盯的是现在。它连续采集活动、等待、SQL和资源状态,回答“系统此刻是否偏离正常”,成熟的监控还应在越界时保留关联时间窗口。
巡检看得更慢、更宽:索引是否不可用、冗余或长期未被使用,表空间还能撑多久,备份是否成功且经过恢复验证,参数、权限和容灾配置有没有潜在风险。很多巡检项在业务毫无感觉时就该被发现。
诊断则围绕具体异常组织证据。它把告警时间、AAS结构、相关会话、SQL及执行计划、阻塞链、日志和最近变更放在一起,提出能够被证伪的根因假设,并通过更多证据加以验证。
监控提供现场,巡检寻找隐患,诊断决定下一步查什么。把三者混成一块大屏,往往只会得到更大的大屏。
以空间问题为例:监控发现剩余空间越过阈值;巡检结合增长趋势、自动扩展上限与存储余量提示隐患;诊断再查清是正常增长,还是异常作业、未清理归档或大事务制造了突增。扩容能解除眼前压力,却未必消除增长失控的原因。三个环节衔接起来,才可能同时减少停机与重复投入。
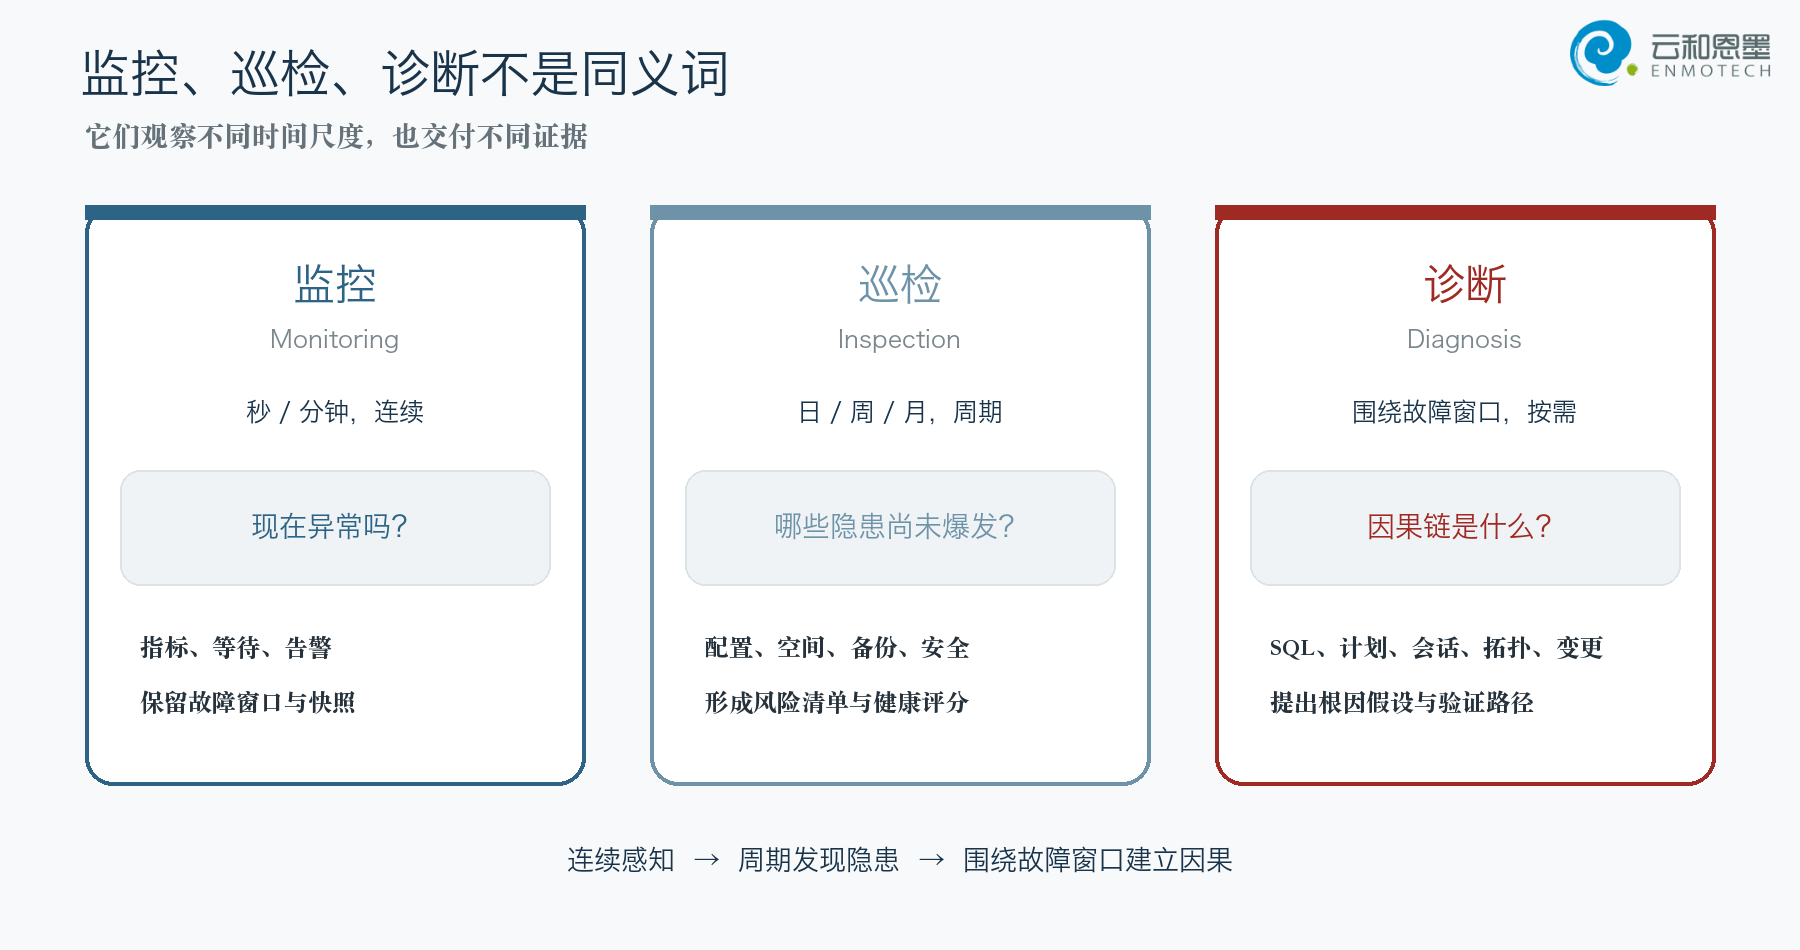
图3:监控提供现场,巡检寻找隐患,诊断组织证据并验证根因假设,它们的时间尺度、问题和交付物均不同。
把云和恩墨的Bethune产品放进这段历史,同样可以看到一条清晰的路线(如图4所示)。产品自2015年已活跃于市场,随后由公有云免费版Bethune走向专业巡检软件Bethune Pro;2018年再以Bethune Pro2把实时监控与智能巡检平台化;2019年8月发布的新一代Bethune X采用无Agent模式,去掉原有Oracle资料库,采用开源组件构建底层架构,并引入流式计算引擎,同时还新增了动态风险评分,以及告警和性能“双下钻”。
流式计算引擎提升了持续采集与规则计算的实时性,为告警后的下钻分析提供更接近异常时刻的数据。动态风险评分把多项监控指标按权重汇总为随状态变化的风险与健康得分,帮助DBA在多套数据库中确定查看顺序。
我们注意到,Bethune的产品路线逐步把服务现场中反复执行的动作固化下来,明确提出从发现问题、下钻定位到建议优化、解决验证的处理链,并把对象、配置、安全与性能纳入巡检。实时监控负责捕捉变化,巡检知识库负责提前扫风险,“双下钻”把问题根因带到SQL、会话和对象,自动化能力则接住处置与验证。
“双下钻”尤其值得放到这一背景下理解:告警下钻从已触发的异常出发,性能下钻从活动趋势及其影响者出发。两种入口最终都回到相同的数据库、时间窗口与证据。若告警与分析页面各说各话,DBA仍要靠手工对表完成最后一段判断,平台化的价值就打了折扣。
2025年3月,Bethune X 6发布,重新强调轻量化:经过前期相关能力在zCloud监控模块中的持续演进,此次独立版本面向的典型环境是10-30套数据库、1-3种类型、缺少专职DBA。到2026年7月发布的6.8.0版,Bethune X已支持30余种数据库,并与zCloud 6.8.0共同引入“1+X”多智能体、三级风险管控和全流程操作审计。
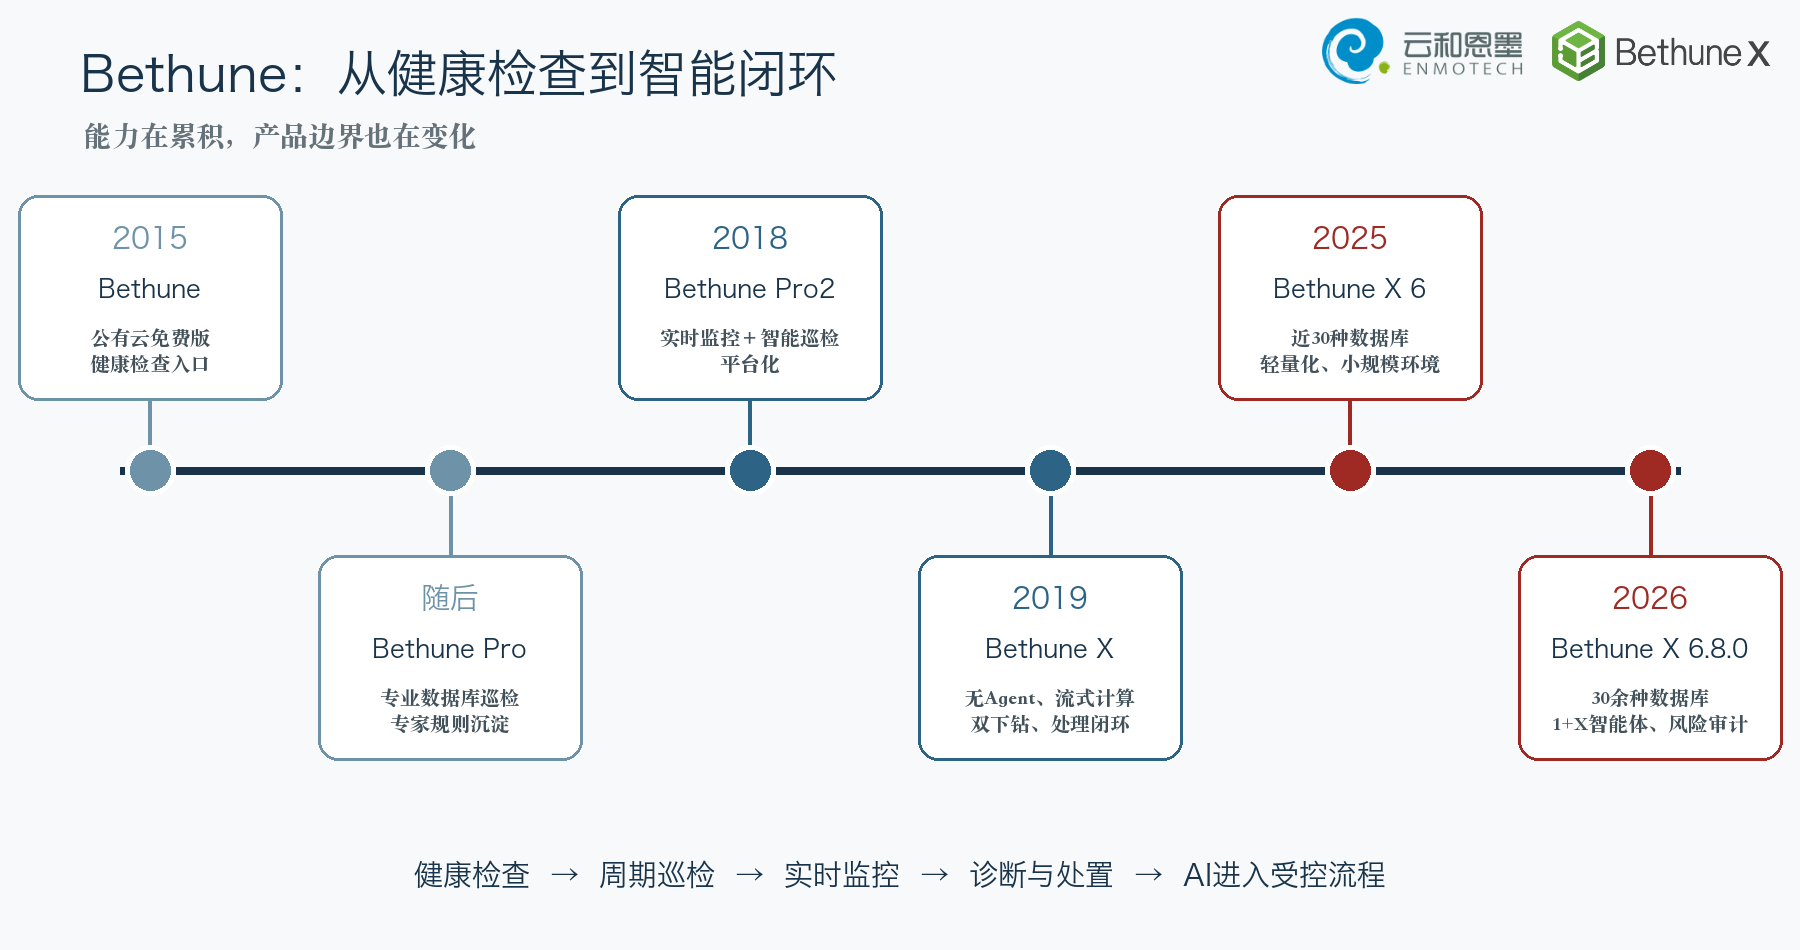
图4:Bethune的产品能力从健康检查、专业巡检,逐步扩展到实时诊断、受控处置与智能体协作。
我判断一个监控平台有没有闭环,不是看它有没有“一键修复”,而是看动作前后是否使用同一条证据链。以锁阻塞为例:AAS和活动会话数突然升高,平台先保留告警快照与阻塞链;诊断再确认根阻塞会话、相关SQL、事务持续时间及业务来源;处置时评估终止会话、协调应用提交或回滚、限流等方案的影响;执行后继续观察AAS、业务时延和阻塞是否复发。
验证还要排除一种假象:处置后AAS降低,可能只是流量退潮,甚至是请求失败得更快。应尽量在可比较的业务负载下,核对成功交易的时延、错误率、吞吐量和资源消耗;涉及长事务时,还要关注终止会话后的回滚是否仍占用资源。执行命令成功,只是动作结束,业务是否恢复才是验收。
最后一步最容易被忽略。一次处置成功,不应只留下“告警已关闭”,还应记录触发条件、证据、审批人、执行动作和结果。复盘后应根据根因性质,把经验写回告警规则、巡检项、发布检查、基线或处置手册。这样,同类故障才能更早被发现,也能沿用已经验证过的处理步骤。只有形成可以复用的规则或处置知识,闭环才算完成。
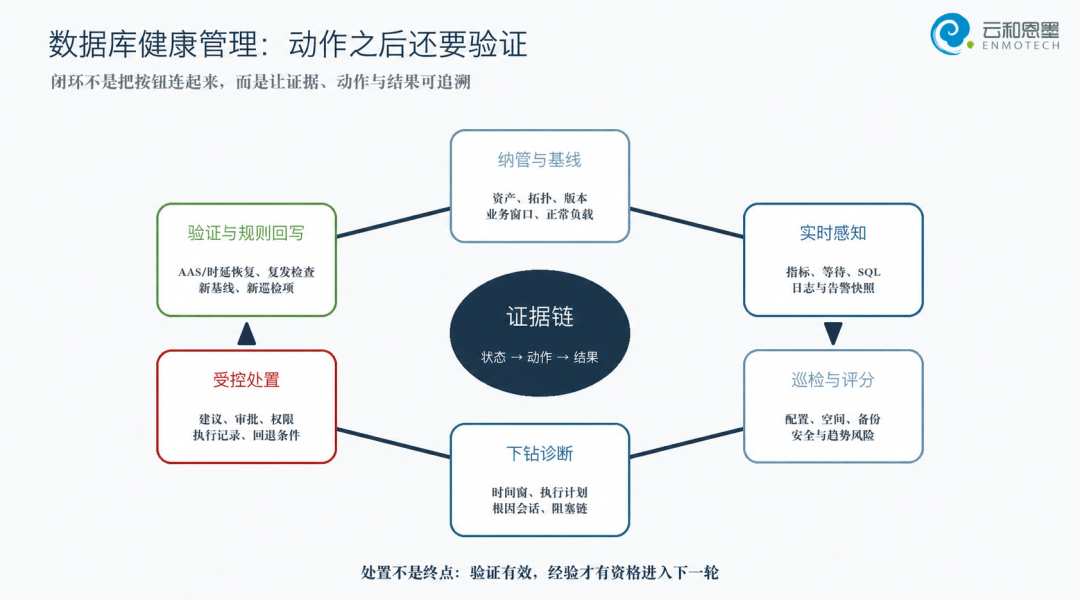
图5:健康管理闭环把状态、证据、动作、结果与规则回写连在一起。
还要提醒一点,动态风险评分很适合做入口:几十套库同时运行时,DBA需要先知道哪一套值得看。但90分不代表安全,60分也不等于马上故障。分数取决于指标权重、阈值、采样窗口和业务场景。核心交易库的日志切换频率、报表库的并行度、测试库的备份要求,本来就不该套一张试卷。
靠谱的健康分应能下钻到扣分项、原始证据和规则版本,并允许按系统等级调整基线;缺少这些解释条件,汇总分数本身不能支持处置决策。
当证据链和处置流程能够被平台连续记录,AI才有条件分担线索整理和初步判断。
2026年7月17日,云和恩墨发布的zCloud与Bethune X的6.8.0版本均加入“1+X”多智能体协同模型(如图6所示):首席调度官(主控智能体)负责理解需求、拆解任务、路由调度和整合结果;资源定位、告警分析、巡检处理、性能分析、故障诊断、指标监测和安装部署7个专家智能体按任务参与,必要时并行调用。它适合把日志、指标、SQL和知识库汇总成一条解释路径,减少人在多个页面之间来回搬运证据。
但AI建议不能绕过生产控制。杀会话、改参数、建索引和扩容都可能产生二次影响。因此,生产落地还应明确对象范围、最小权限、人工审批、超时与回退条件,并留下完整审计。模型可以缩短“看懂”的时间;谁有权动生产、什么时候动、失败后怎么办,仍需由制度与平台共同回答。
经验进入知识库也需要验证。适用版本、业务前提、证据出处和处理结果,应随案例一起保存;失效的规则要修订,失败的建议同样值得记录。否则,AI只是在更快地复制旧判断。让经验能够被检验、更新,才是从个人能力走向组织能力的关键。
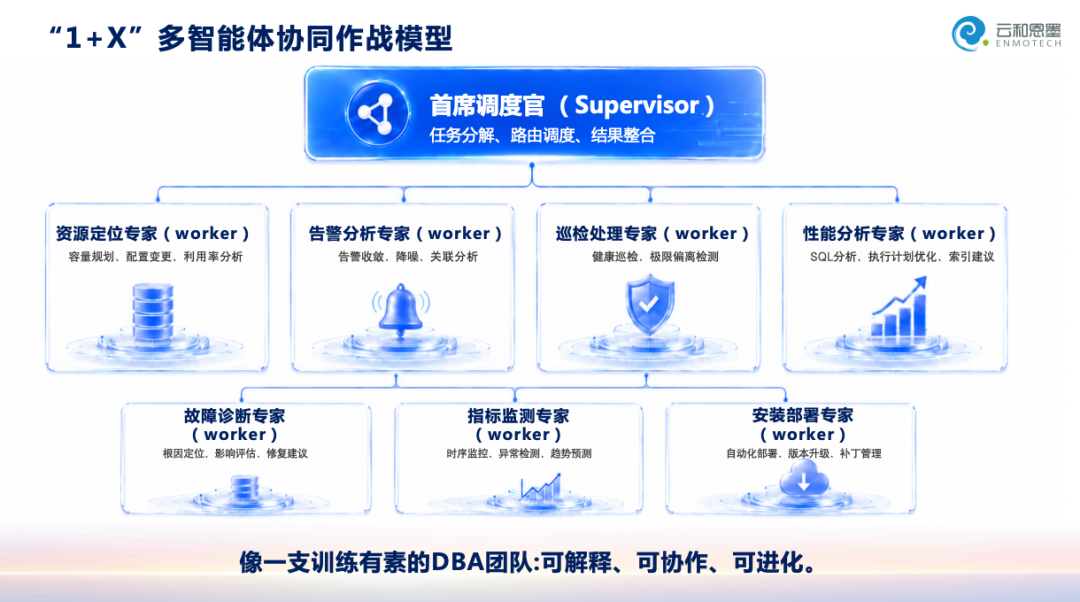
图6:Bethune X与zCloud的6.8.0版本引入“1+X”多智能体协同模型。
将前面的历史和方法落到平台选型上,可以归结为五个可以验证的问题。
-
能否保住现场?告警触发时是否保存关联指标、SQL、会话、阻塞、日志和变更窗口,而不是只留一条消息。
-
能否解释规则?阈值、基线、健康分和诊断建议能否回到原始证据,规则是否分版本、可按业务调整。
-
能否安全动手?高风险动作是否经过权限、审批、范围限制和审计;有没有明确的停止与回退条件。
-
能否证明有效?执行后是否自动比较AAS、时延、错误率或容量趋势,而不是把“执行成功”当成“问题解决”。
-
能否学会下一次?复盘结果能否沉淀为自定义巡检项、知识条目或新的基线,让组织减少重复救火。
这五个问题共同检验的,不是平台替人完成多少操作,也不是能够展示多少曲线,而是它能否把现场、判断、处置、验证和复盘连成一条可追溯的工作链。高风险判断和关键动作仍由人负责,平台则负责保存现场、组织证据、记录过程,并把经过验证的结果沉淀为下一班值守人员可以复用的规则和处置记录。做到这一点,监控平台才能真正提升数据库业务连续性。
-
Kyle Hailey, History of Database Monitoring, 2016. https://www.slideshare.net/khailey/history-of-database-monitoring
-
SolarWinds,收购Confio公告,2013-10-07
-
Confio,Ignite 8.3 Quick Start Guide,2013
-
Percona,Percona Monitoring and Management Beta发布公告,2016-04-18
-
Google,Site Reliability Engineering,第6章 Monitoring Distributed Systems,2016
-
墨天轮,《拒绝“裸奔”:资深DBA眼中最值得拥有的7款数据库监控工具》,2025-12-16,https://www.modb.pro/db/2000801141832622080
-
Redgate,Marking deployments in Redgate Monitor 14,2024-06-20,https://www.red-gate.com/blog/marking-deployments-in-redgate-monitor-14/
-
云和恩墨,《重磅发布丨云和恩墨新一代数据库实时监控和智能巡检平台:BethuneX》,2019-09-16,https://enmotech.com/technology/article/883
-
数据和云,《化繁为简:数据库运维人员应该知道这些…》,2019-09-19,https://mp.weixin.qq.com/s/q7Ebja75w0V3LPnJbQbtnw
-
云和恩墨,《Bethune X 6发布:为小规模数据库环境打造轻量化智能监控巡检利器》,2025-04-03,https://mp.weixin.qq.com/s/GN0IL2msIcjIaFnpskJsjw
-
Google,Site Reliability Engineering,第15章 Postmortem Culture: Learning from Failure,2016
-
云和恩墨,《云蒸霞蔚:从“第二存储”到多智能体协作,云和恩墨充实数据基础设施产品矩阵》,2026-07-20,https://enmotech.com/about/news/1654
-
云和恩墨,《AI Agent这么火,DBA团队到底怎么用?》,2026-08-10,https://enmotech.com/technology/article/1663