AI不是突然降临数据库运维:它先把经验写成规则,再把异常变成证据,最后才在权限与审计的边界内学会行动。
在上一篇「多元数据库时代的平台化转向」中,我们讨论了数据库管理平台如何把资产、权限、流程和审计汇成一套运维控制面。到了这一篇,控制面的另一层意义显现出来:大模型(LLM)能写出像样的故障分析,却不会凭空知道生产库在哪里、刚才发生了什么变更、谁有权执行动作。AI要真正进入数据库运维,先要接上可信的现场,也要学会遵守平台的边界。
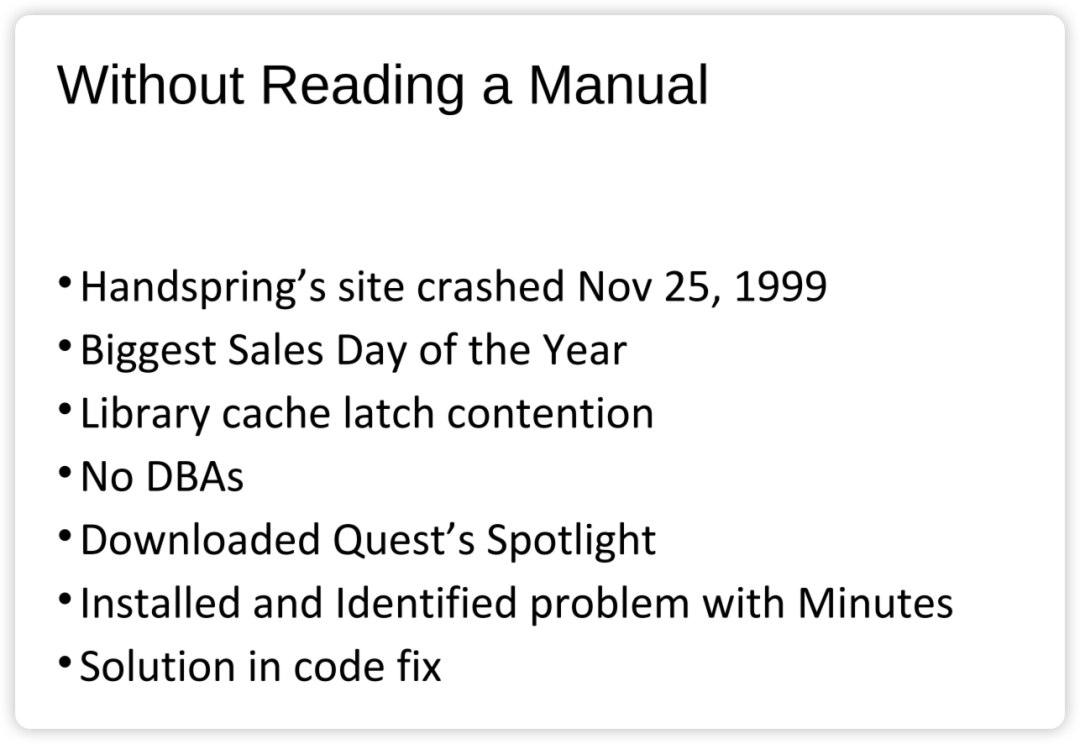
图1:数据库性能监控与可视化专家凯尔·海利(Kyle Hailey)在《History of Database Monitoring》中演示的Handspring故障案例,列出了当时的症状、诊断工具与解决方案。
当企业同时管理几十甚至几百套库、主机、中间件和应用,麻烦变成信号太多。AIOps汇集指标、日志、事件与工单,用基线、异常检测和事件关联区分噪声与真正需要响应的变化;目标是把凌晨两点收到的几十条告警,整理成少数可以调查的事件。
这种需求并非大模型时代才出现。Google在2016年的《Site Reliability Engineering》著作里介绍过Outalator:系统保存、标注并合并告警,把多条通知归到一次事故下,避免把“告警数”误当“事故数”。这说明,即使不依赖机器学习,告警收敛也是规模化运维必须解决的工程问题。
例如应用变更发布后连接池不断重试,应用错误、连接数、CPU、锁等待与存储延迟可能一起上升。逐条阈值会各自报警,事件关联可以按时间、依赖关系和历史模式把它们摆到同一时间线上。但相关性仍不是因果性:把五十条告警合成一条,不能单凭相似度决定重启哪台机器。
动态基线也不是简单地把报警线画得会移动。它要区分工作日和节假日、月末批处理与日常交易,还要解释为什么本次偏离值得叫醒值班人员。对数据库而言,业务响应变慢、等待事件结构改变和近期变更同时出现,通常比单看CPU超线更有调查价值。
zCloud给出了一个更贴近数据库现场的做法:指标按变化速度设置不同采集频率;告警条件可结合当前值、近期趋势和预测值;再以级别抑制、对象合并和发送频率控制收敛重复通知。比如Oracle RAC集群同一表空间在多个实例上重复报警,平台可合并为一条集群级事件。这里的规则、预测和收敛各有用途,不宜笼统写成“AI自动找出根因”。
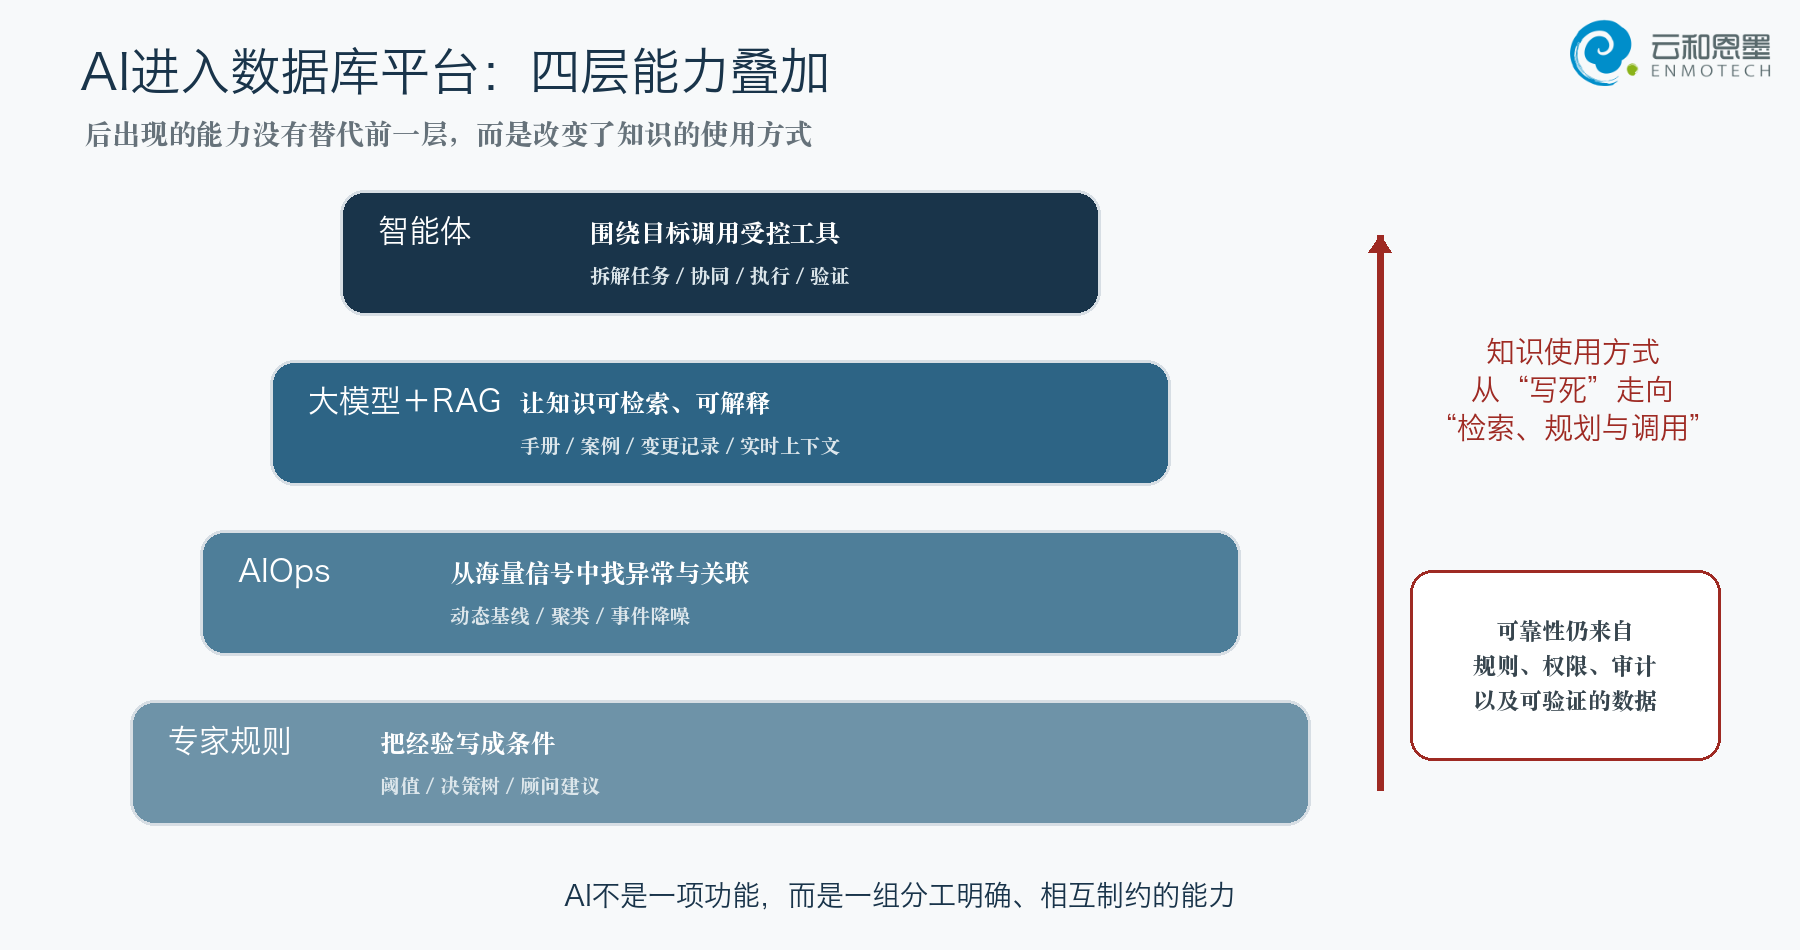
图2:专家规则、AIOps、大模型与智能体逐层叠加;告警收敛并不等于因果诊断。
大模型带来的第一项实用变化,是让人能用自然语言询问复杂问题。过去,DBA要在手册、标准作业流程、故障复盘和版本说明之间反复搜索;现在它能解释术语、整理检查步骤,并把技术结论改写给研发、值班人员或管理者。但通用模型并不知道企业自己的拓扑、补丁、变更和事故。
2020年的RAG(检索增强生成)研究把生成模型与外部可检索知识结合,使模型能够参考可更新的资料;答案能否准确列出出处,仍取决于检索、标注和核验方式。zCloud的产品定义把WaaS(智慧即服务)和专家经验知识库列为平台能力,并允许用户更新案例;2026年发布的新版zCloud进一步明确了专家经验RAG知识库与多智能体团队的结合。对数据库管理平台而言,知识不只要“能搜到”,还要按数据库类型、版本、适用架构和权限过滤。
RAG仍不保证正确。旧版手册可能排在检索结果最前面,某次事故的应对办法也可能只适用于另一种拓扑。高质量诊断须把文档出处和版本,与实时指标、SQL、等待事件及变更记录放进同一证据包。没有现场数据支撑的“根因”,只能算待验证的解释。
因此,知识库的工作不止是上传文档。案例需要标注适用版本、处理前提和过期时间;一次故障结束后,也应把被证伪的假设一并记录。这样下一次检索才可能同时给出可用经验和不能照搬的理由,避免“旧答案”披着新语气重新进入生产。
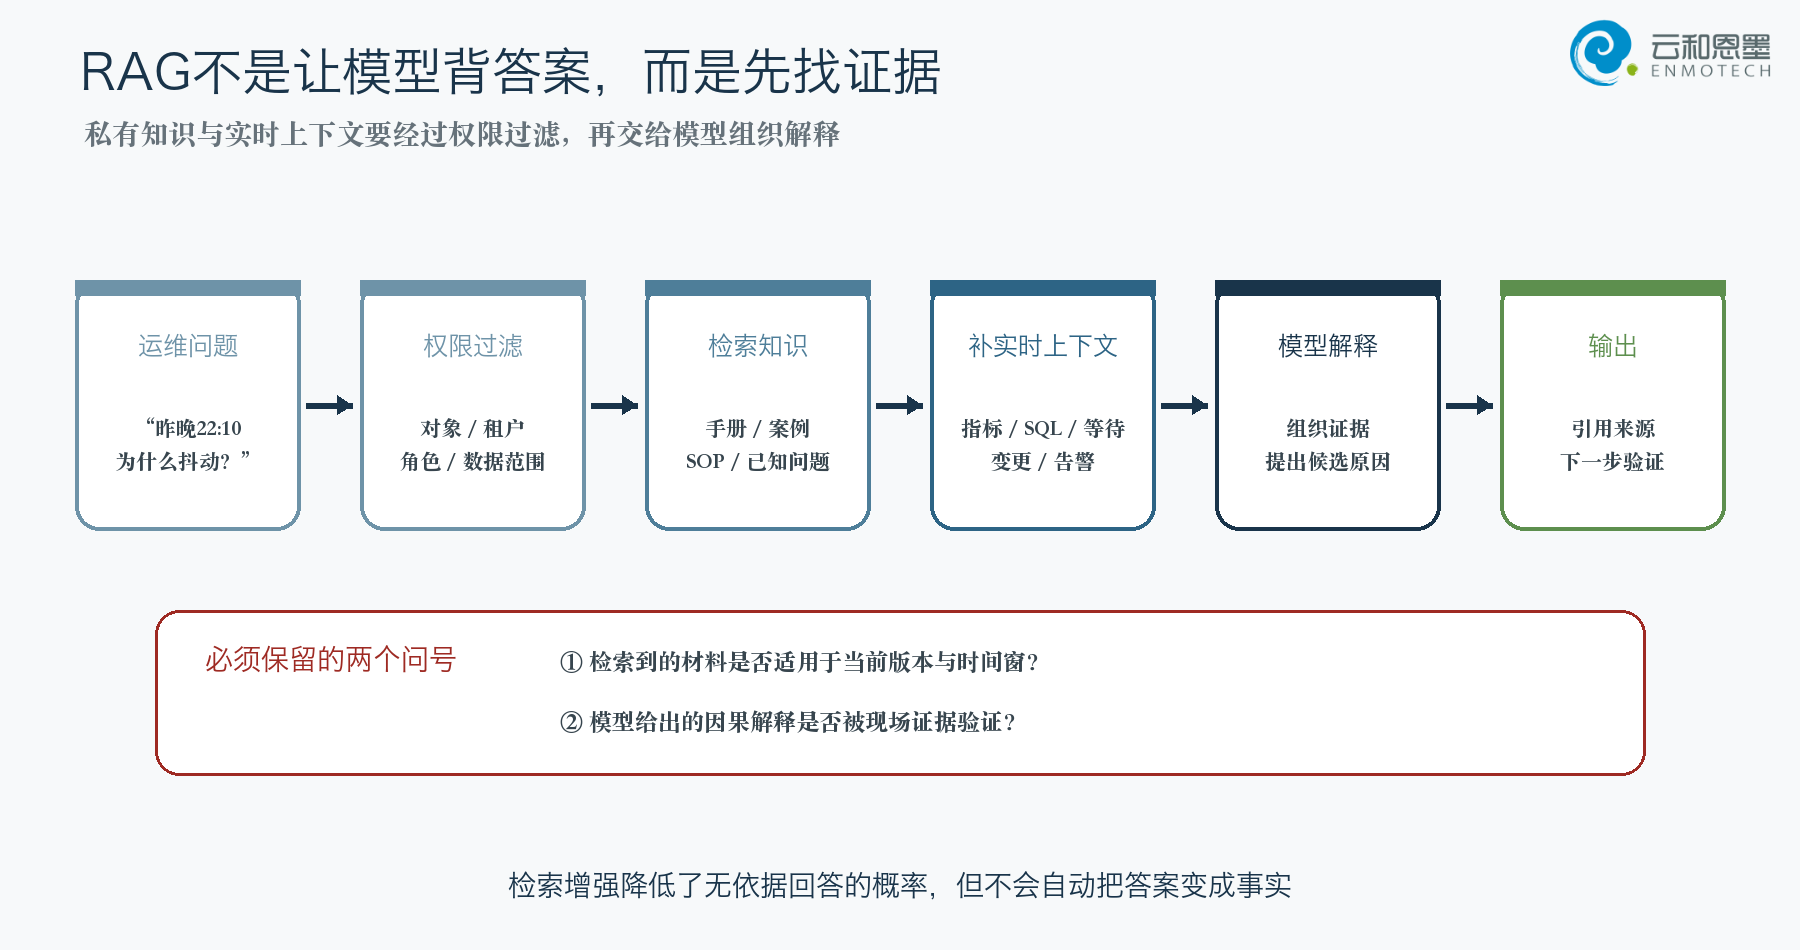
图3:RAG提供知识线索,实时数据与版本核验决定结论能否成立。
聊天助手通常停在“告诉你怎么做”;智能体(Agent)则围绕目标读取上下文、选择工具、执行一步、检查结果,再决定下一步。调查“昨晚22:10核心交易库为什么抖动”,就必须先定位数据库资产,读取监控数据(包括ASH),核对变更,比对基线,必要时生成工单。
这类任务还有一个容易被忽略的要求:每一步都应保留它使用的对象和时间范围。若性能分析读取的是故障发生前十分钟,而告警分析却汇总了整个夜班,两个看似一致的结论仍可能谈论不同问题。任务编排必须保存上下文,也要允许人随时修正调查范围。
2022年的ReAct研究展示了模型交替推理和调用外部工具的工作方式。这给运维带来新的交互可能,却没有消除工具侧的治理责任:资产决定看哪套库,租户和角色权限决定能调用什么,任务中心保存过程,审计记录谁发起、谁批准、执行结果如何。zCloud的租户隔离、开放API、执行引擎和任务调度,正是让智能体接入平台时可利用的基础能力。
因此,规则、AIOps、大模型/RAG和智能体不是相互淘汰的四代产品。规则给出确定性,AIOps处理规模与噪声,大模型提供知识入口,智能体负责组织任务和调用能力。智能体越接近行动,越需要规则、监测数据和事件关联提供约束与可验证的证据。
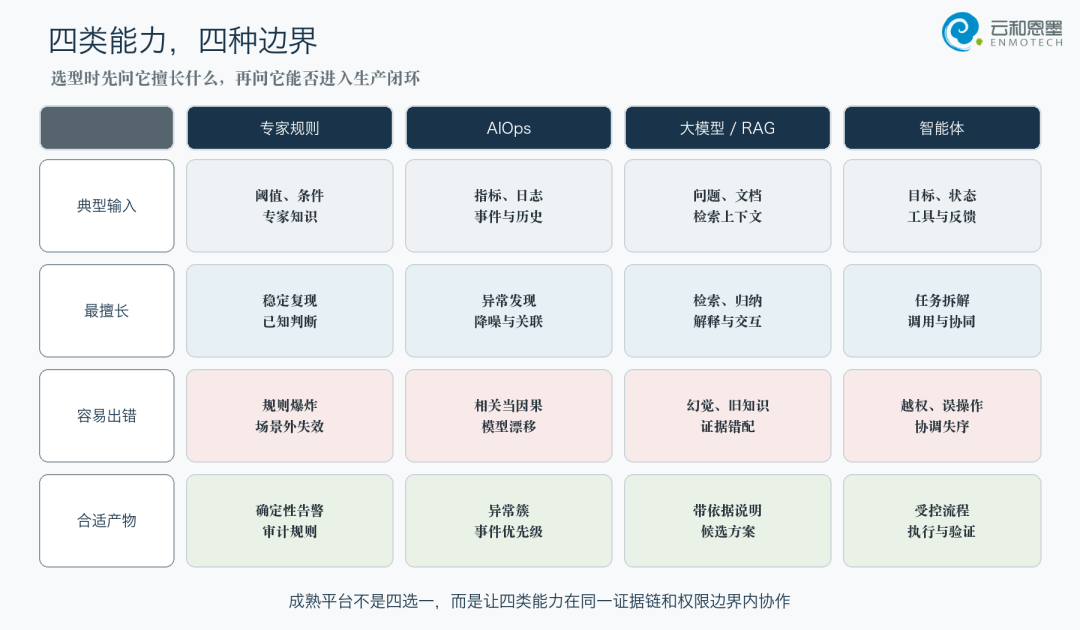
图4:四类能力的输入、长处和失误方式各不相同,需要在同一平台内协作。
2026年7月,zCloud与Bethune X同步发布6.8.0版本,并引入“1+X”多智能体协作模式。它包含七类专家智能体(如图5所示):资源定位、告警分析、巡检分析、指标分析、性能分析、根因诊断和安装部署,由一个主助手(主控智能体)接收人类的自然语言任务并按需调度。
它的价值不在于多开七个聊天窗口。一次性能故障里,资源定位先确认业务等级与拓扑;指标和性能分析读取时序变化、等待与慢SQL;告警分析还原事件链;根因诊断将证据和假设汇成结论。若各自使用不同对象和时间窗,只会得到几份相互矛盾的报告。协作必须共享任务状态、证据出处与验证结果。
更实用的提问不是“这套库有什么问题”,而是“昨晚发布后,交易超时是否与连接耗尽有关”。前者容易得到宽泛巡检清单;后者限定了业务、时间和待验证的假设。多智能体只有围绕这样的具体任务组织取证,才可能把并行分析变成一条可供DBA复核的调查链。
zCloud智能体遵循“对话即操作、多库统一管控、安全可审计”:只读查询和幂等触发操作可直接执行,DDL、SSH写指令、数据修改等高风险动作须经人工确认。它还依托内置的“知识飞轮”机制,持续积累用户环境的专属记忆,包括实例命名习惯、业务术语和高频运维模式;记忆不存储业务原始数据、密钥、密码等敏感信息,并隔离在用户的私有环境内。这种设计有助于系统逐步适应用户的运维场景,并将可复用的处理经验留在组织内。
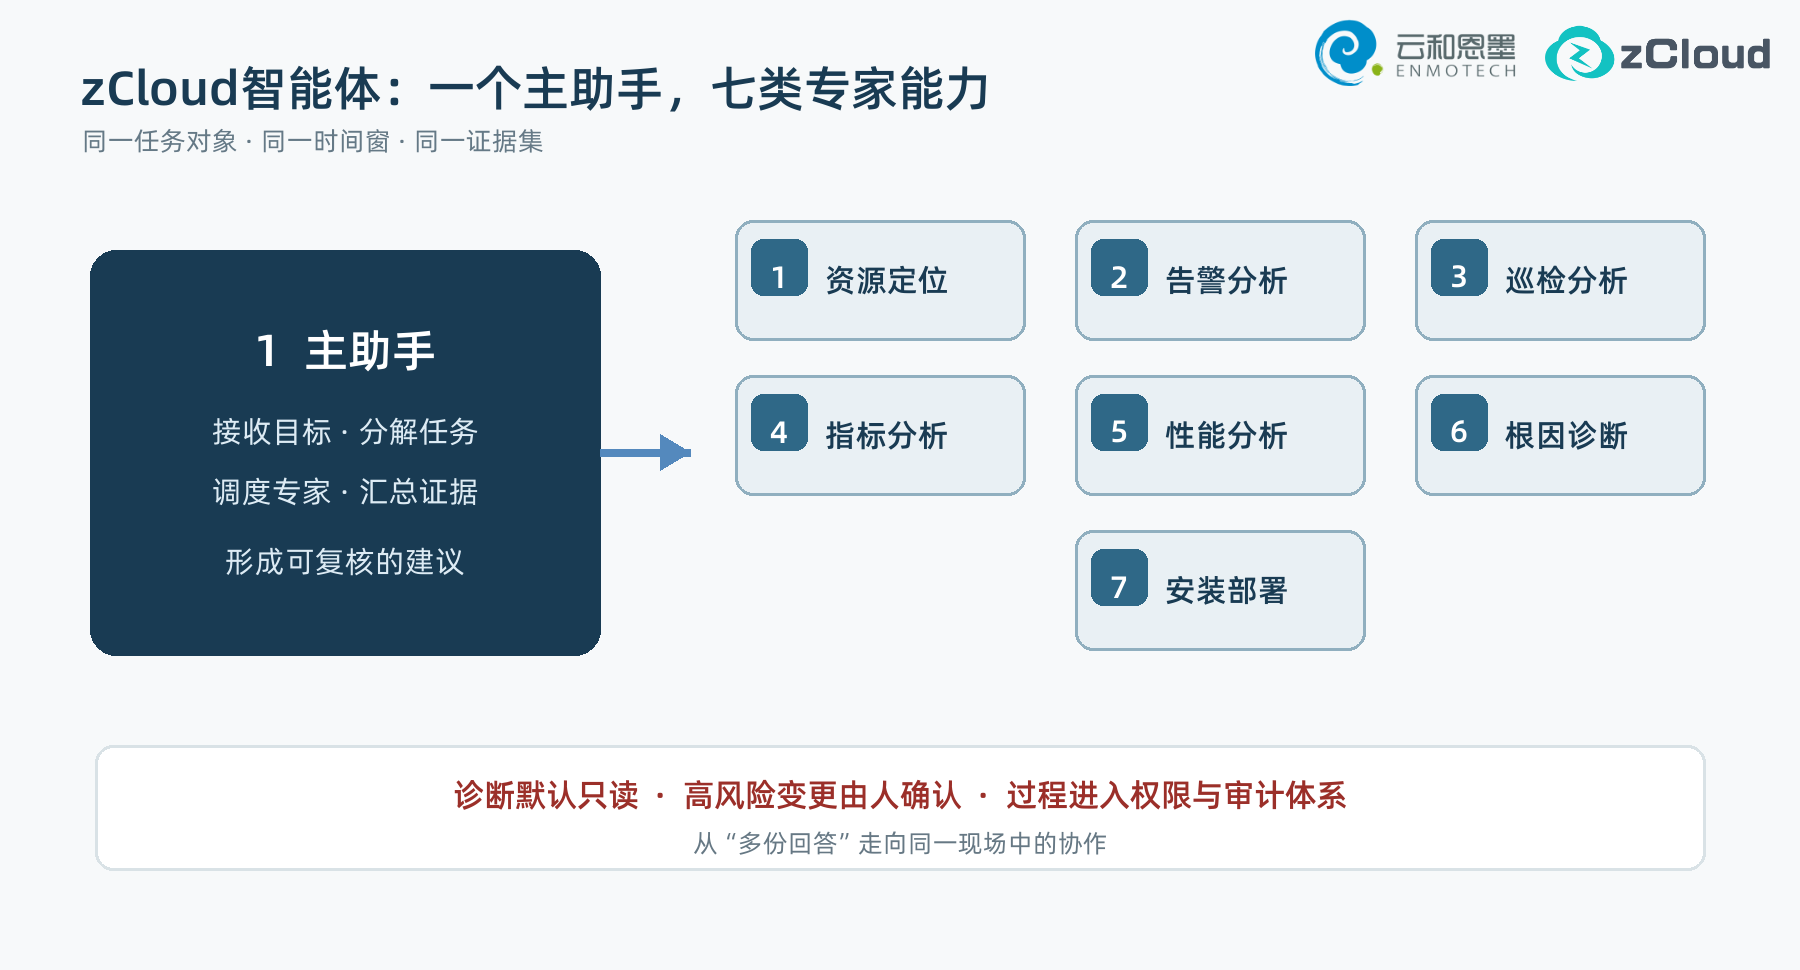
图5:zCloud智能体协作机制--主助手调度七类专家,在统一证据与治理边界内工作。
数据库运维的自动化等级不能只按模型能力划分,还要按动作风险划分。读取指标、生成报告和整理检查清单可以自动完成;终止会话、修改参数、创建索引、主备切换和恢复数据会改变生产状态,审批与回退要求应随风险上升。所谓自治,是让每一步都在可证明的边界内发生。
-
对象要收窄:明确数据库、租户、业务等级和时间窗,避免模糊目标遍历全部生产资源。
-
权限要最小:诊断默认只读;变更权限与对象、动作和有效时间绑定。
-
证据要可追:结论附采集时间、查询语句、文档版本和原始记录;智能体调用的工具及其结果,也应关联到同一次任务记录。
-
风险要分级:高风险动作由人批准,审批时展示影响范围与回退方案。
-
执行要可停:设置超时、并发限制和熔断,失败后停止扩大影响。
-
结果要验证:重新采集指标,检查问题是否缓解,并将过程写入审计。
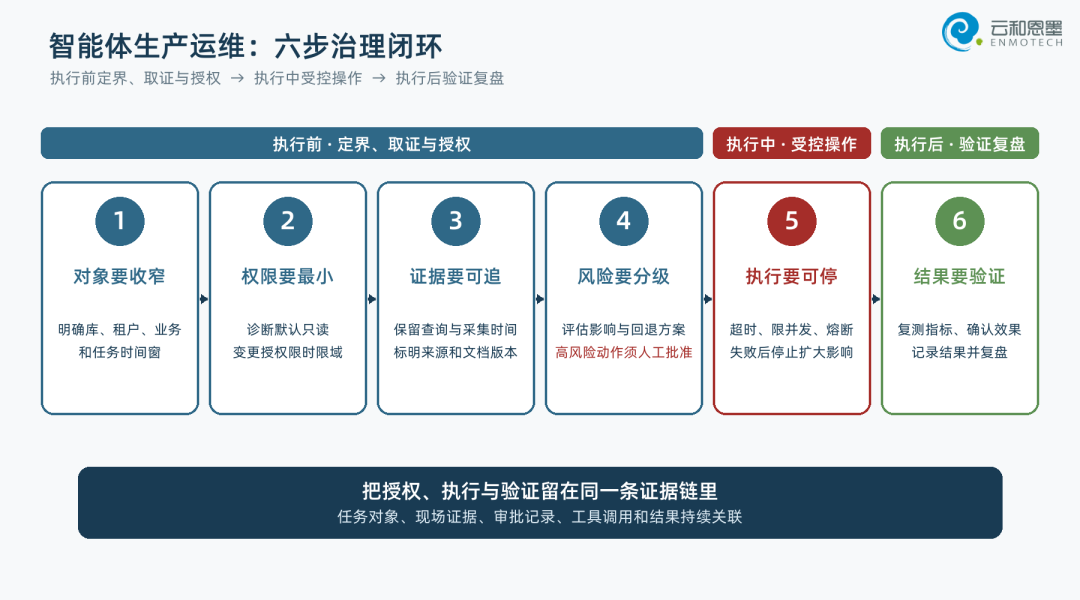
图6:智能体参与生产运维的六步治理闭环,覆盖执行前授权、执行中控制和执行后验证。
回看这条路线,数据库运维中的AI不是从聊天框起步的。Spotlight把诊断线索画出来,ADDM把分析逻辑写入产品,AIOps在规模化环境中整理信号,RAG接入企业知识,智能体再把多种能力串成一次完整任务。每一步都在把DBA的经验从个人记忆搬到可复用的平台。
真正值得衡量的,也不是回答像不像专家,而是一次任务有没有引用现场证据,别人能否复核;是否守住对象和权限,失败时能否及时止损,并按预案恢复或补救;结论能否沉淀为下一次可用的规则与案例。AI让判断更快,平台让判断有据可查,最终责任仍由人和制度承担。
-
Kyle Hailey:《History of Database Monitoring》,2016。https://www.slideshare.net/khailey/history-of-database-monitoring
-
Oracle:Diagnosing and Resolving Performance Problems Using ADDM(Oracle Database 10g 官方教程)。https://www.oracle.com/ocom/groups/public/%40otn/documents/webcontent/279697.htm
-
Google SRE:《Tracking Outages》,2016。https://sre.google/sre-book/tracking-outages/
-
IBM:《What is AIOps?》。https://www.ibm.com/think/topics/aiops
-
Patrick Lewis等:《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,2020。https://arxiv.org/abs/2005.11401
-
Shunyu Yao等:《ReAct: Synergizing Reasoning and Acting in Language Models》,2022。https://arxiv.org/abs/2210.03629
-
云和恩墨:《zCloud技术白皮书》
-
云和恩墨:《云和恩墨发布两款新品及三项升级,为智能体企业愿景实现完善产品布局》,2026年7月29日。https://enmotech.com/about/news/1657
-
云和恩墨:《云和恩墨联合超聚变发布三款软硬一体化解决方案,为AI时代数据底座装上“专业运维大脑”》,2026年8月10日。https://enmotech.com/about/news/1664
-
云和恩墨:《ACDU·中国行北京站丨云和恩墨聚焦AI数据库演进与多智能体运维》,2026年8月31日。https://enmotech.com/about/news/1671